Hugging Face släpper 200+ WebGPU-kärnor för lokal AI i webbläsaren
Visar varför WebGPU-kärnorna är relevanta och hur de kan bli en svensk guide om lokal AI i webbläsaren
Guider och nyheter om att köra AI-modeller lokalt.
Visar varför WebGPU-kärnorna är relevanta och hur de kan bli en svensk guide om lokal AI i webbläsaren
Klar svensk genomgång av vad prisskiftet faktiskt betyder för användare av Ollamas betalda planer
Läsaren får en begriplig bild av vad som faktiskt blivit tydligare och hur det påverkar val mellan lokal och hostad AI.
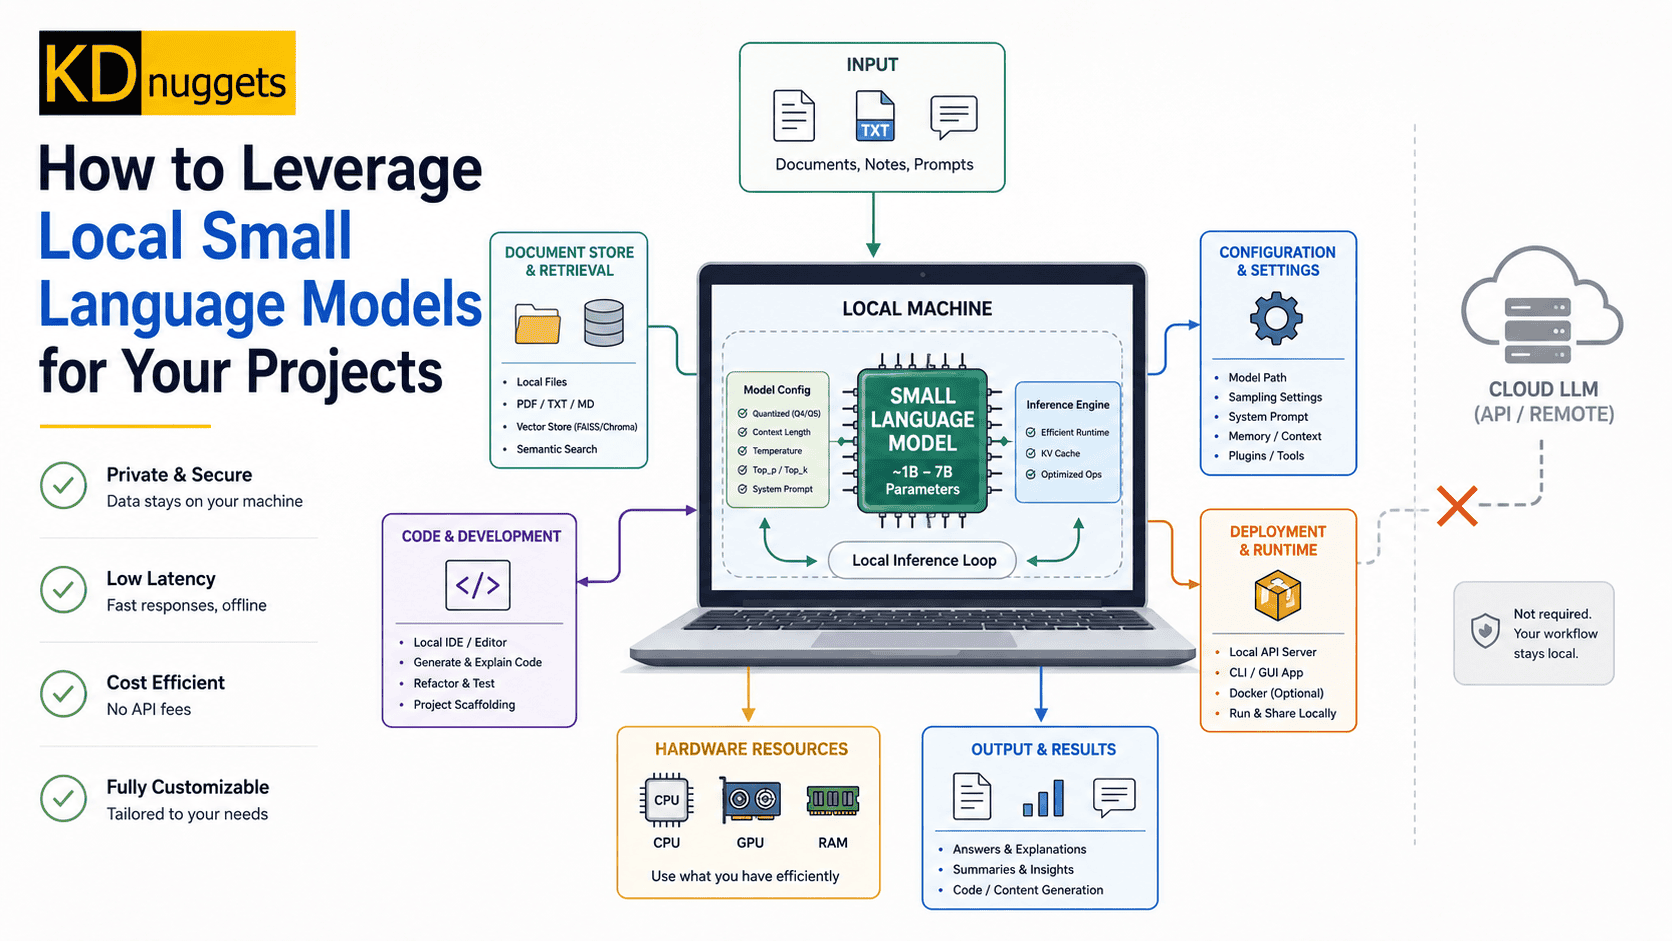
En liten språkmodell på egen hårdvara ger kontroll över data och kostnad. Här är när det lönar sig, hur du väljer modell och hur du kommer igång med
Det populära open-source-projektet llama.cpp har fått en ny dokumentationssajt som samlar introduktioner och guider för lokal modellkörning på ett mer
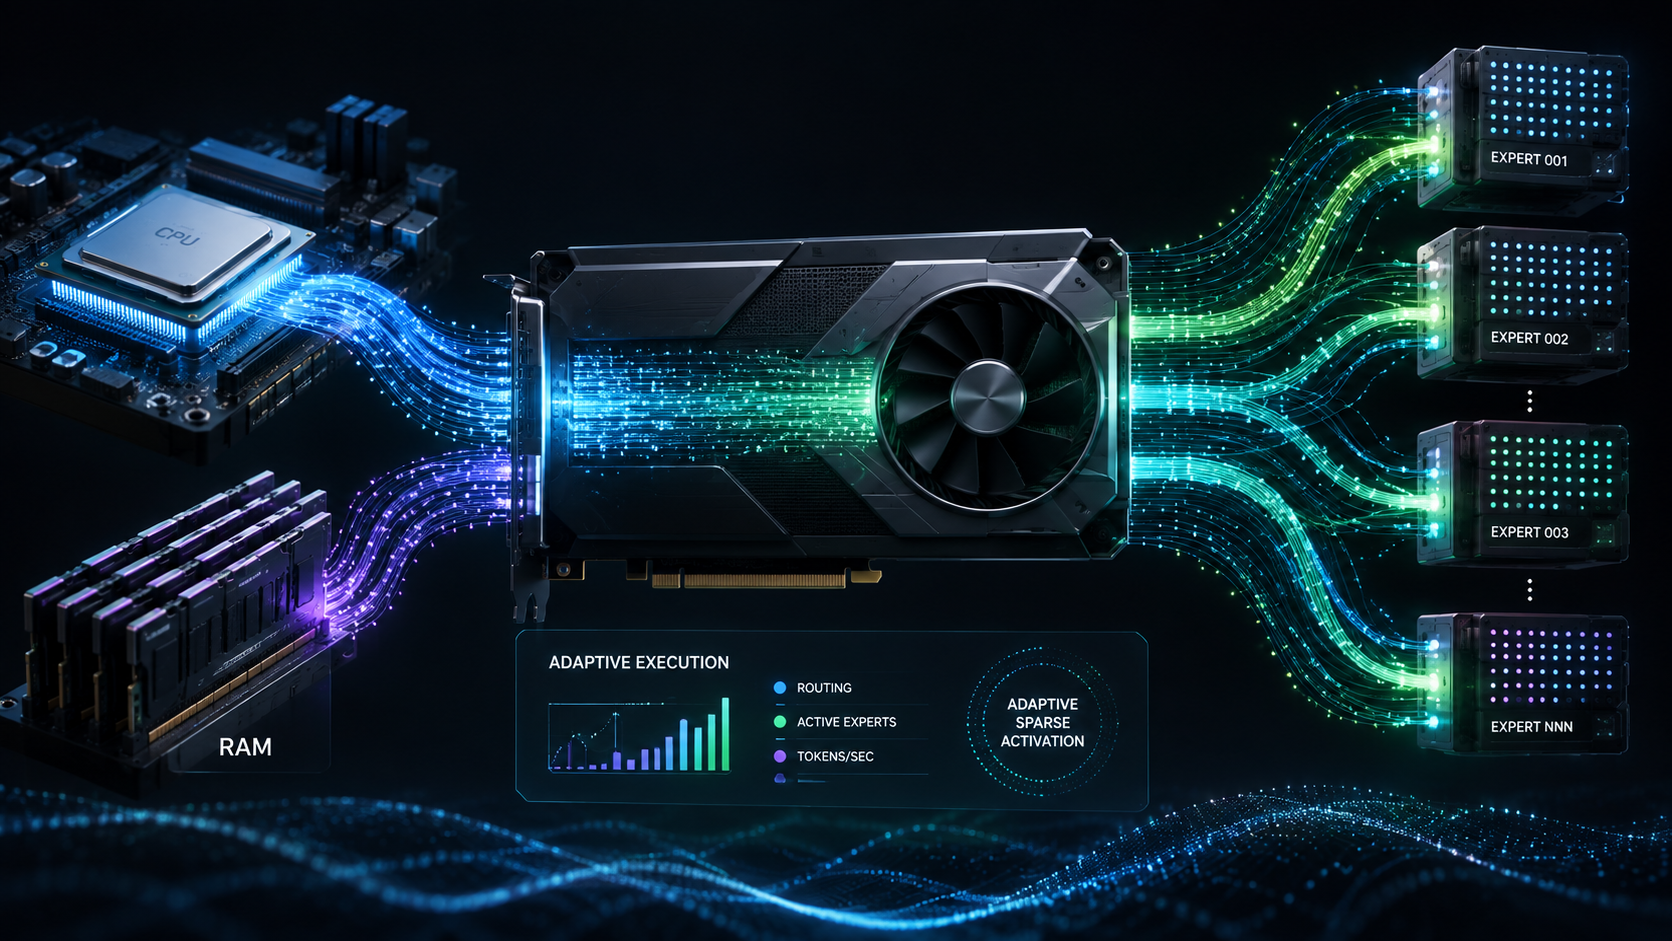
Ett nytt open-source-system kallat FreeToken visar hur mycket större Mixture-of-Experts-modeller kan köras på lokal hårdvara genom att behandla GPU, CPU
Liquid AI har släppt DSpark draft-modeller för LFM2.5 som använder speculative decoding för att öka genereringshastigheten utan att ändra huvudmodellens
Meta-modellen Muse Glimmer går att köra lokalt med llama.cpp och DFlash. Här är stegen, hårdvaran du behöver och hur du verifierar att allt fungerar.
Efter över 20 testade lokala LLM:er behåller XDA-skribenten fyra modeller – en för kodning, en för vardagen, en för resonemang, en för kreativt skrivande.
DSpark-draftmodeller för LFM2.5 gör speculative decoding praktiskt tillgängligt i SGLang och kan ge stora hastighetsvinster utan att byta huvudmodell.
Transformers har stöd för Metal-baserad 2-, 4- och 8-bitars quantization på Apple Silicon och Metal flash attention för snabbare lokal AI.
Open Generative AI är en MIT-licensierad studio för AI-bilder, AI-video, lip sync, workflows och lokal inference.
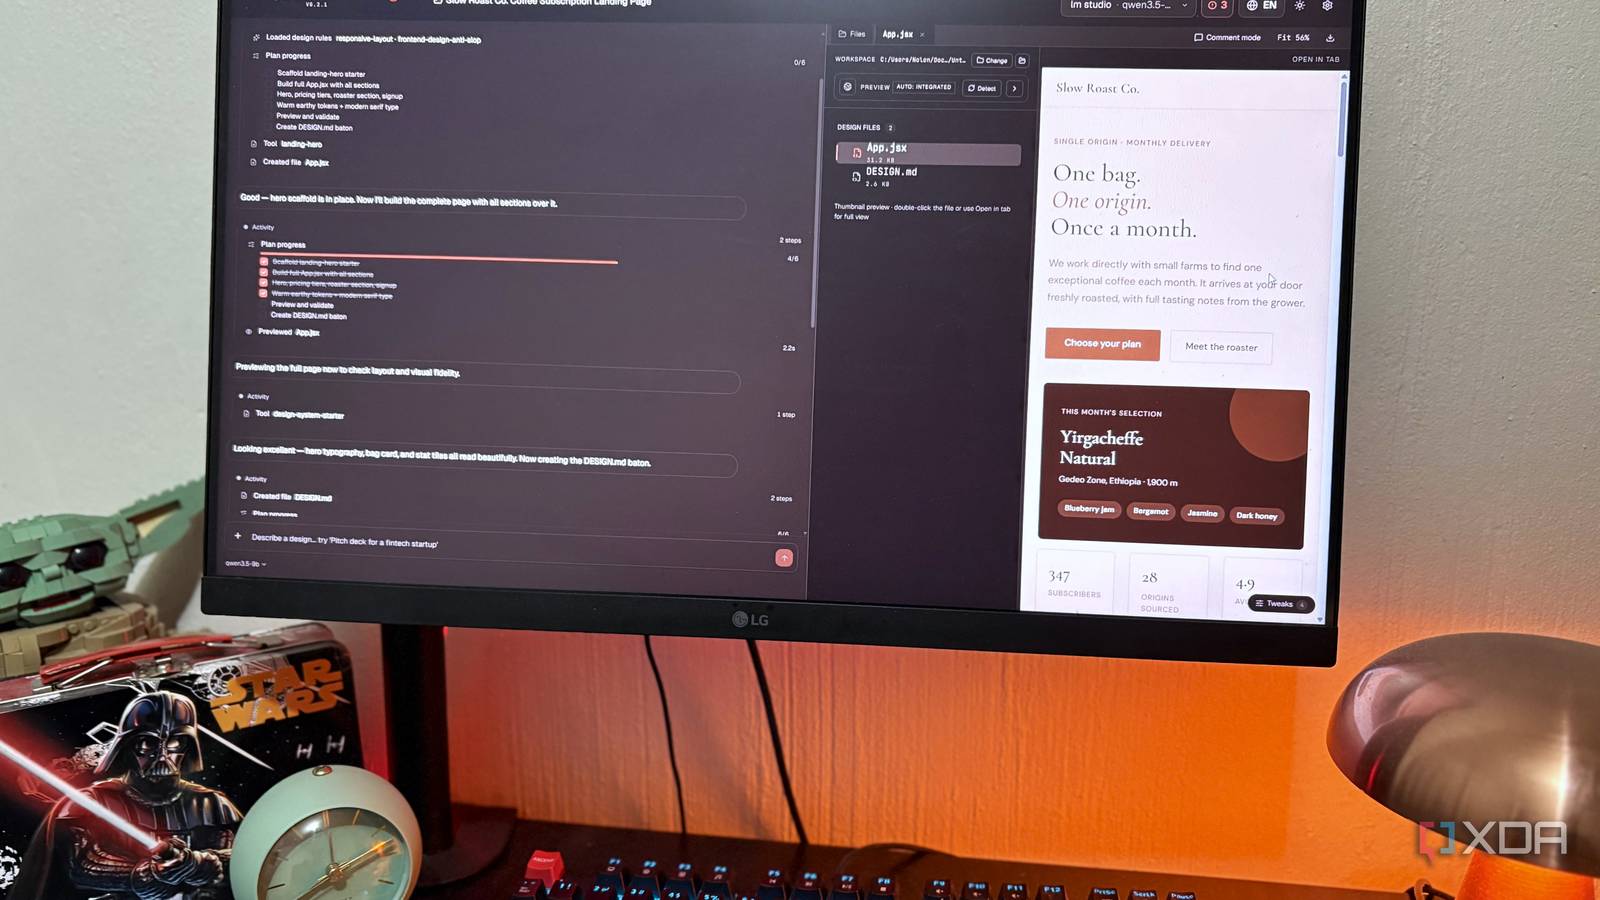
Designoutput är bara kod, så en kodhjärna räcker. XDA-skrivaren Nolen Jonker kör Qwen 3.5 9B lokalt med Open CoDesign och byter ut Claude Design – med
Nvidia har släppt Nemotron 3.5 Lightning, en öppen modell med 30 miljarder parametrar som körs lokalt och är byggd för agenter.
Ollama lägger till Muse Glimmer från Meta Superintelligence Labs. Modellen är multimodal, lokal och riktad mot agentarbetsflöden på Mac.
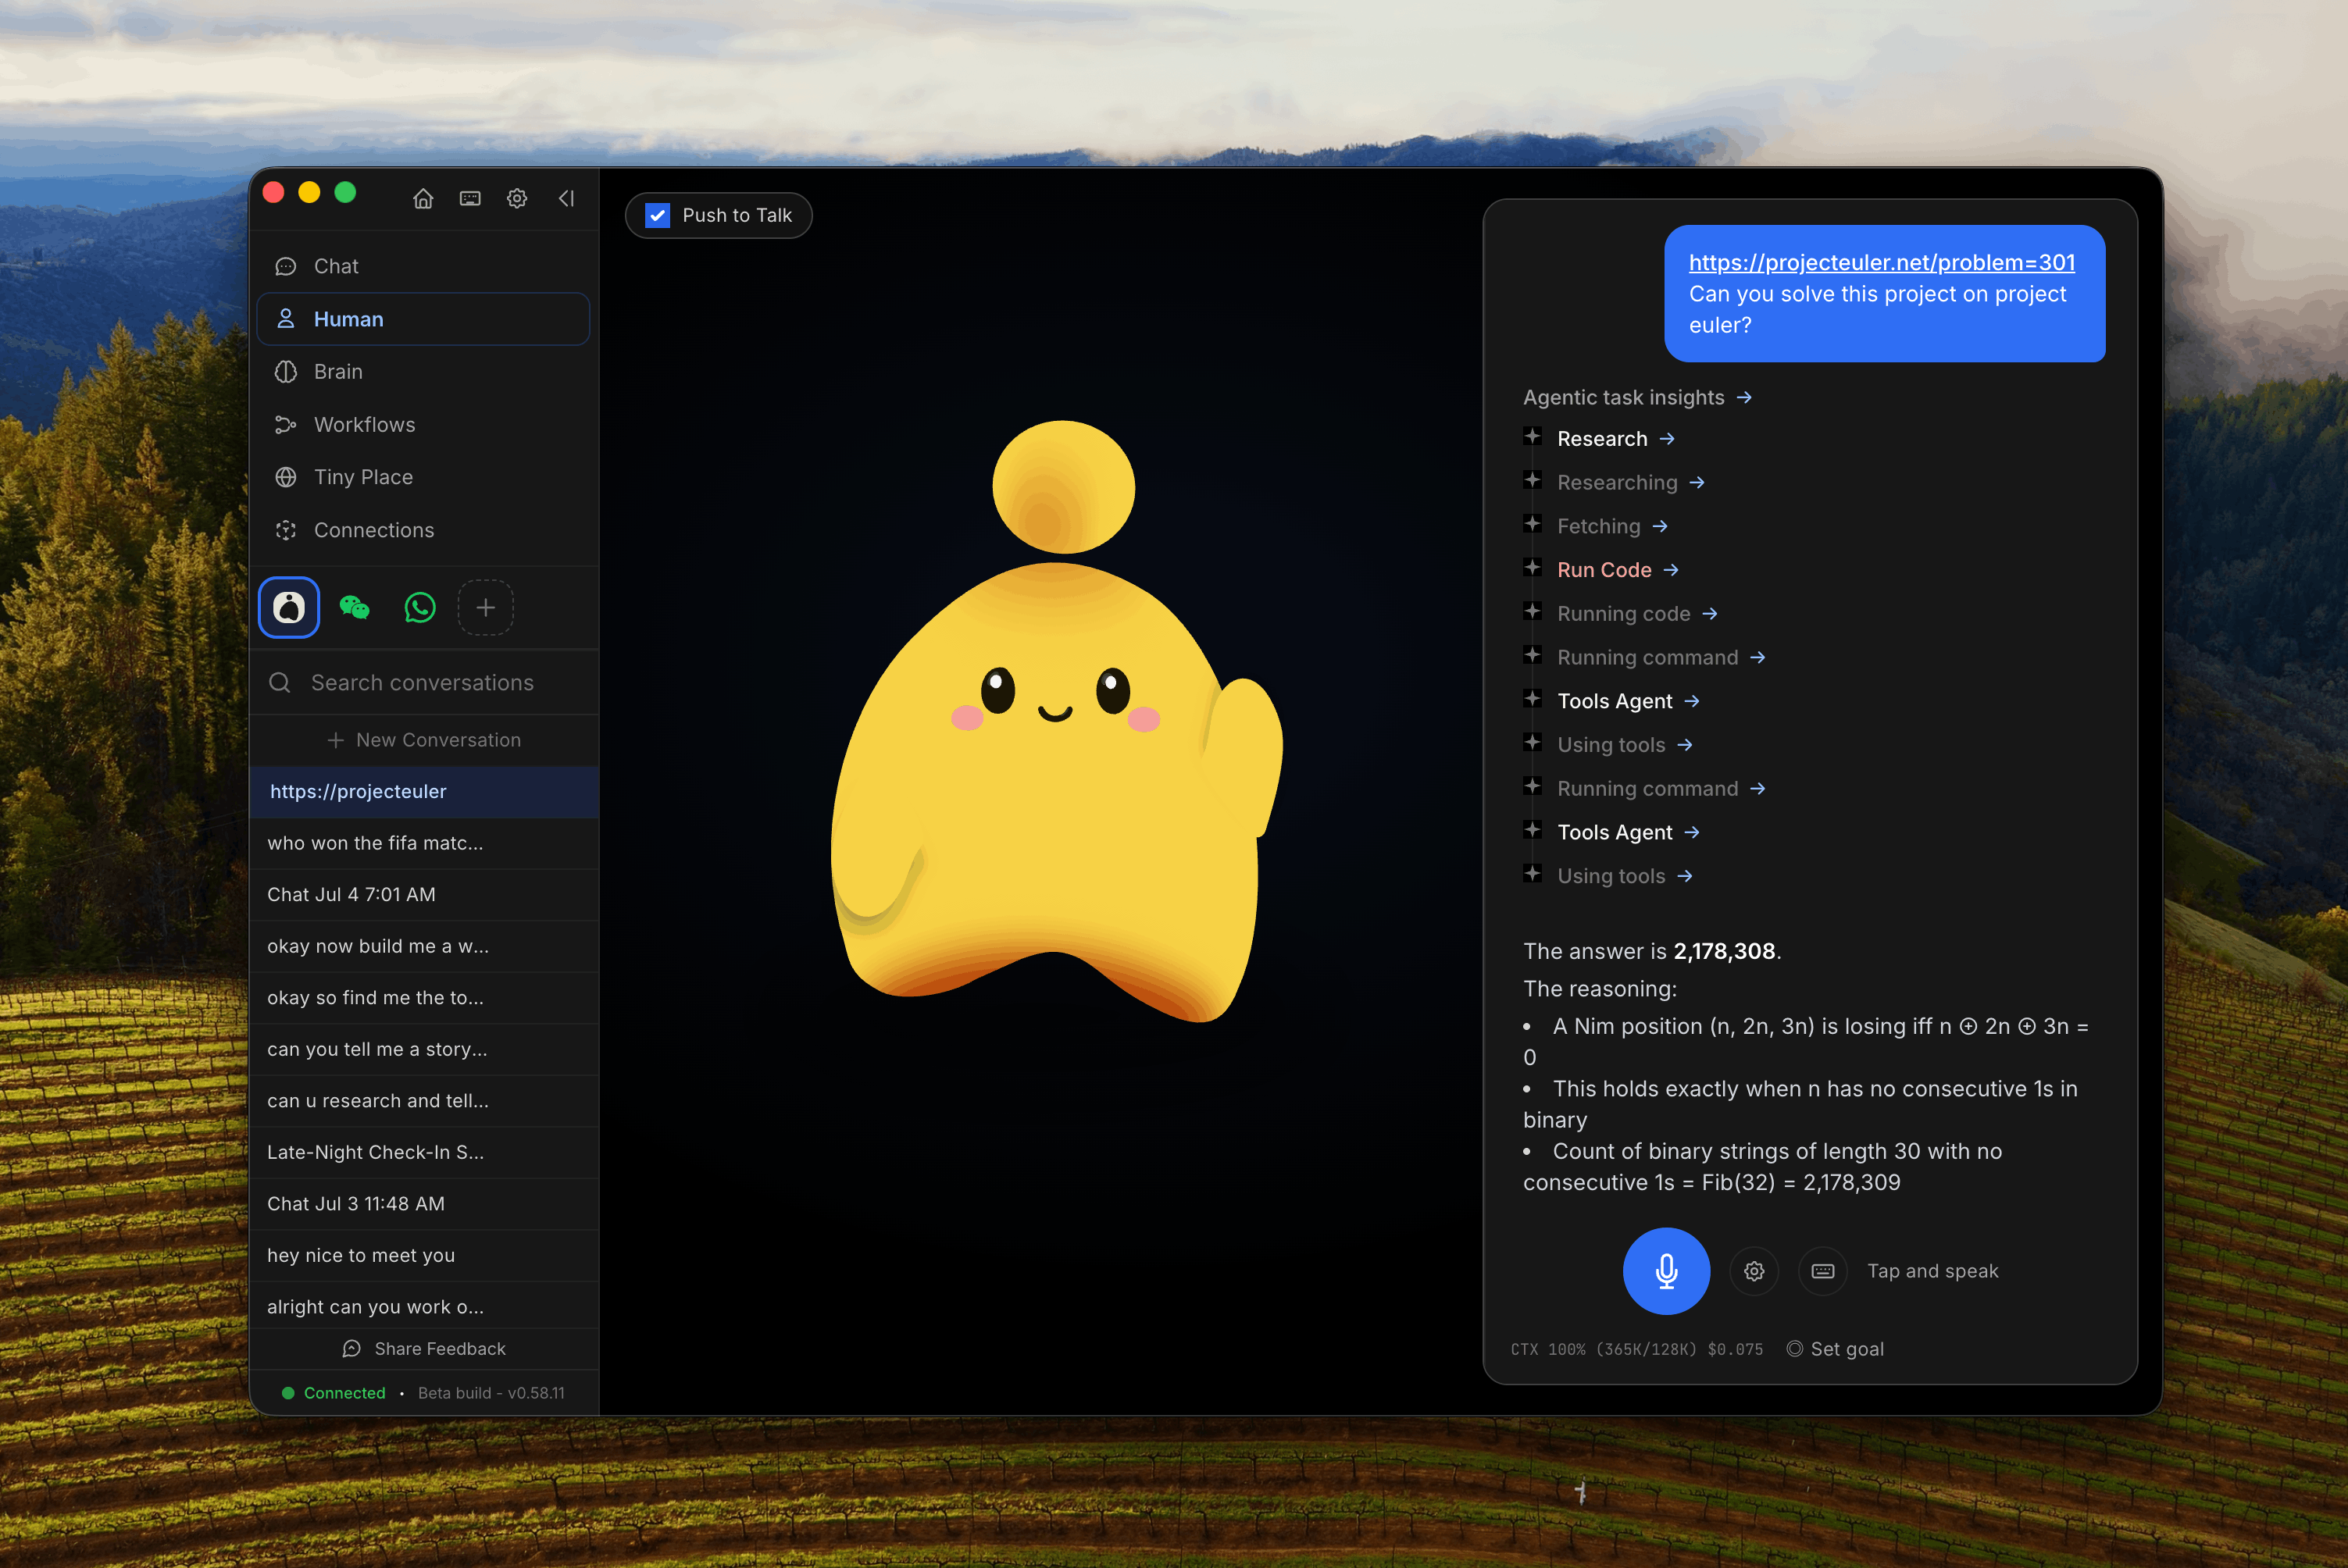
OpenHuman kombinerar lokalt AI-minne, integrationer och agentorkestrering. Vi jämför projektet med Hermes Agent.
AI-destillering låter mindre språkmodeller ärva användbara beteenden från större modeller och gör lokal AI mer praktisk.

Ollama säger att plattformen nu når 8,9 miljoner utvecklare. Det stärker caset för lokal AI med mer kontroll över data och kostnader.

Ollama uppger att plattformen nu betjänar 8,9 miljoner utvecklare och har tagit in 88 miljoner dollar för att bygga vidare på öppna modeller.

AMD Ryzen AI Halo Developer Platform är en kompakt AI-dator för utvecklare som vill köra stora AI-modeller lokalt.

Ollama lyfter förbättrad prestanda och modellstöd med GGUF, viktigt för lokala LLM-flöden och utvecklare.

NVIDIA har publicerat en praktisk guide för DiffusionGemma, en lokal AI-modell för bildgenerering som kör på RTX-grafikkort.

Ollama har släppt två viktiga uppdateringar: en prestandaförbättring för Apple Silicon via MLX-stöd och version 0.30 med bättre GGUF-hantering.

NOOP är en fristående app för WHOOP 4.0 och WHOOP 5.0 som låter dig läsa puls, HRV, sömn och återhämtning lokalt utan moln, konto eller prenumeration.

Svensk analys: Ollama Launch förenklar lokala coding agents. Vad nyheten betyder för AI-utveckling, utvecklare och företag.