Magnitude låter din kodagent köra på lokala modeller – gratis och offline
Magnitude profilerar din Mac, rekommenderar lokala modeller som passar och kopplar in dem i den kodagent du redan använder – gratis, privat och offline.
Nyheter om språkmodeller, multimodala modeller och AI-modeller.
Magnitude profilerar din Mac, rekommenderar lokala modeller som passar och kopplar in dem i den kodagent du redan använder – gratis, privat och offline.
Fem LLM-API:er med gratisnivåer som räcker för prototyper – här är gränserna och när du måste betala.
Google släpper Gemini 3.8 Flash och den säkerhetsinriktade 3.8 Flash Cyber – den tredje Flash-modellen på sex veckor, till samma pris som 3.7 Flash.

Med GRPO kan du finjustera en liten modell för pålitlig strukturerad output. En steg-för-steg-guide baserad på Hugging Faces TRL-metod.
Google DeepMind lanserar WeatherNext 3, sin mest träffsäkra globala väderprognosmodell. Här är vad den kan betyda för beredskap och riskmodeller.
Google släpper Gemini 3.8 Flash och säkerhetsvarianten 3.8 Flash Cyber, den tredje Flash-modellen på sex veckor. Modellval är nu en löpande process.
GPT-6 Astra lanserades 3 september som OpenAI:s mest kraftfulla modell. Resonemangstekniken opaque recurrence gör tankekedjan svår att inspektera.

Anthropics nya toppmodell Claude Fable 5.1 sänker cachepriset 75 procent men producerar 70 procent fler output-tokens. Så räknar du på totalkostnaden.
Förklarar varför dubbelblinda utvärderingar kan spela roll för hur modellpåståenden tolkas
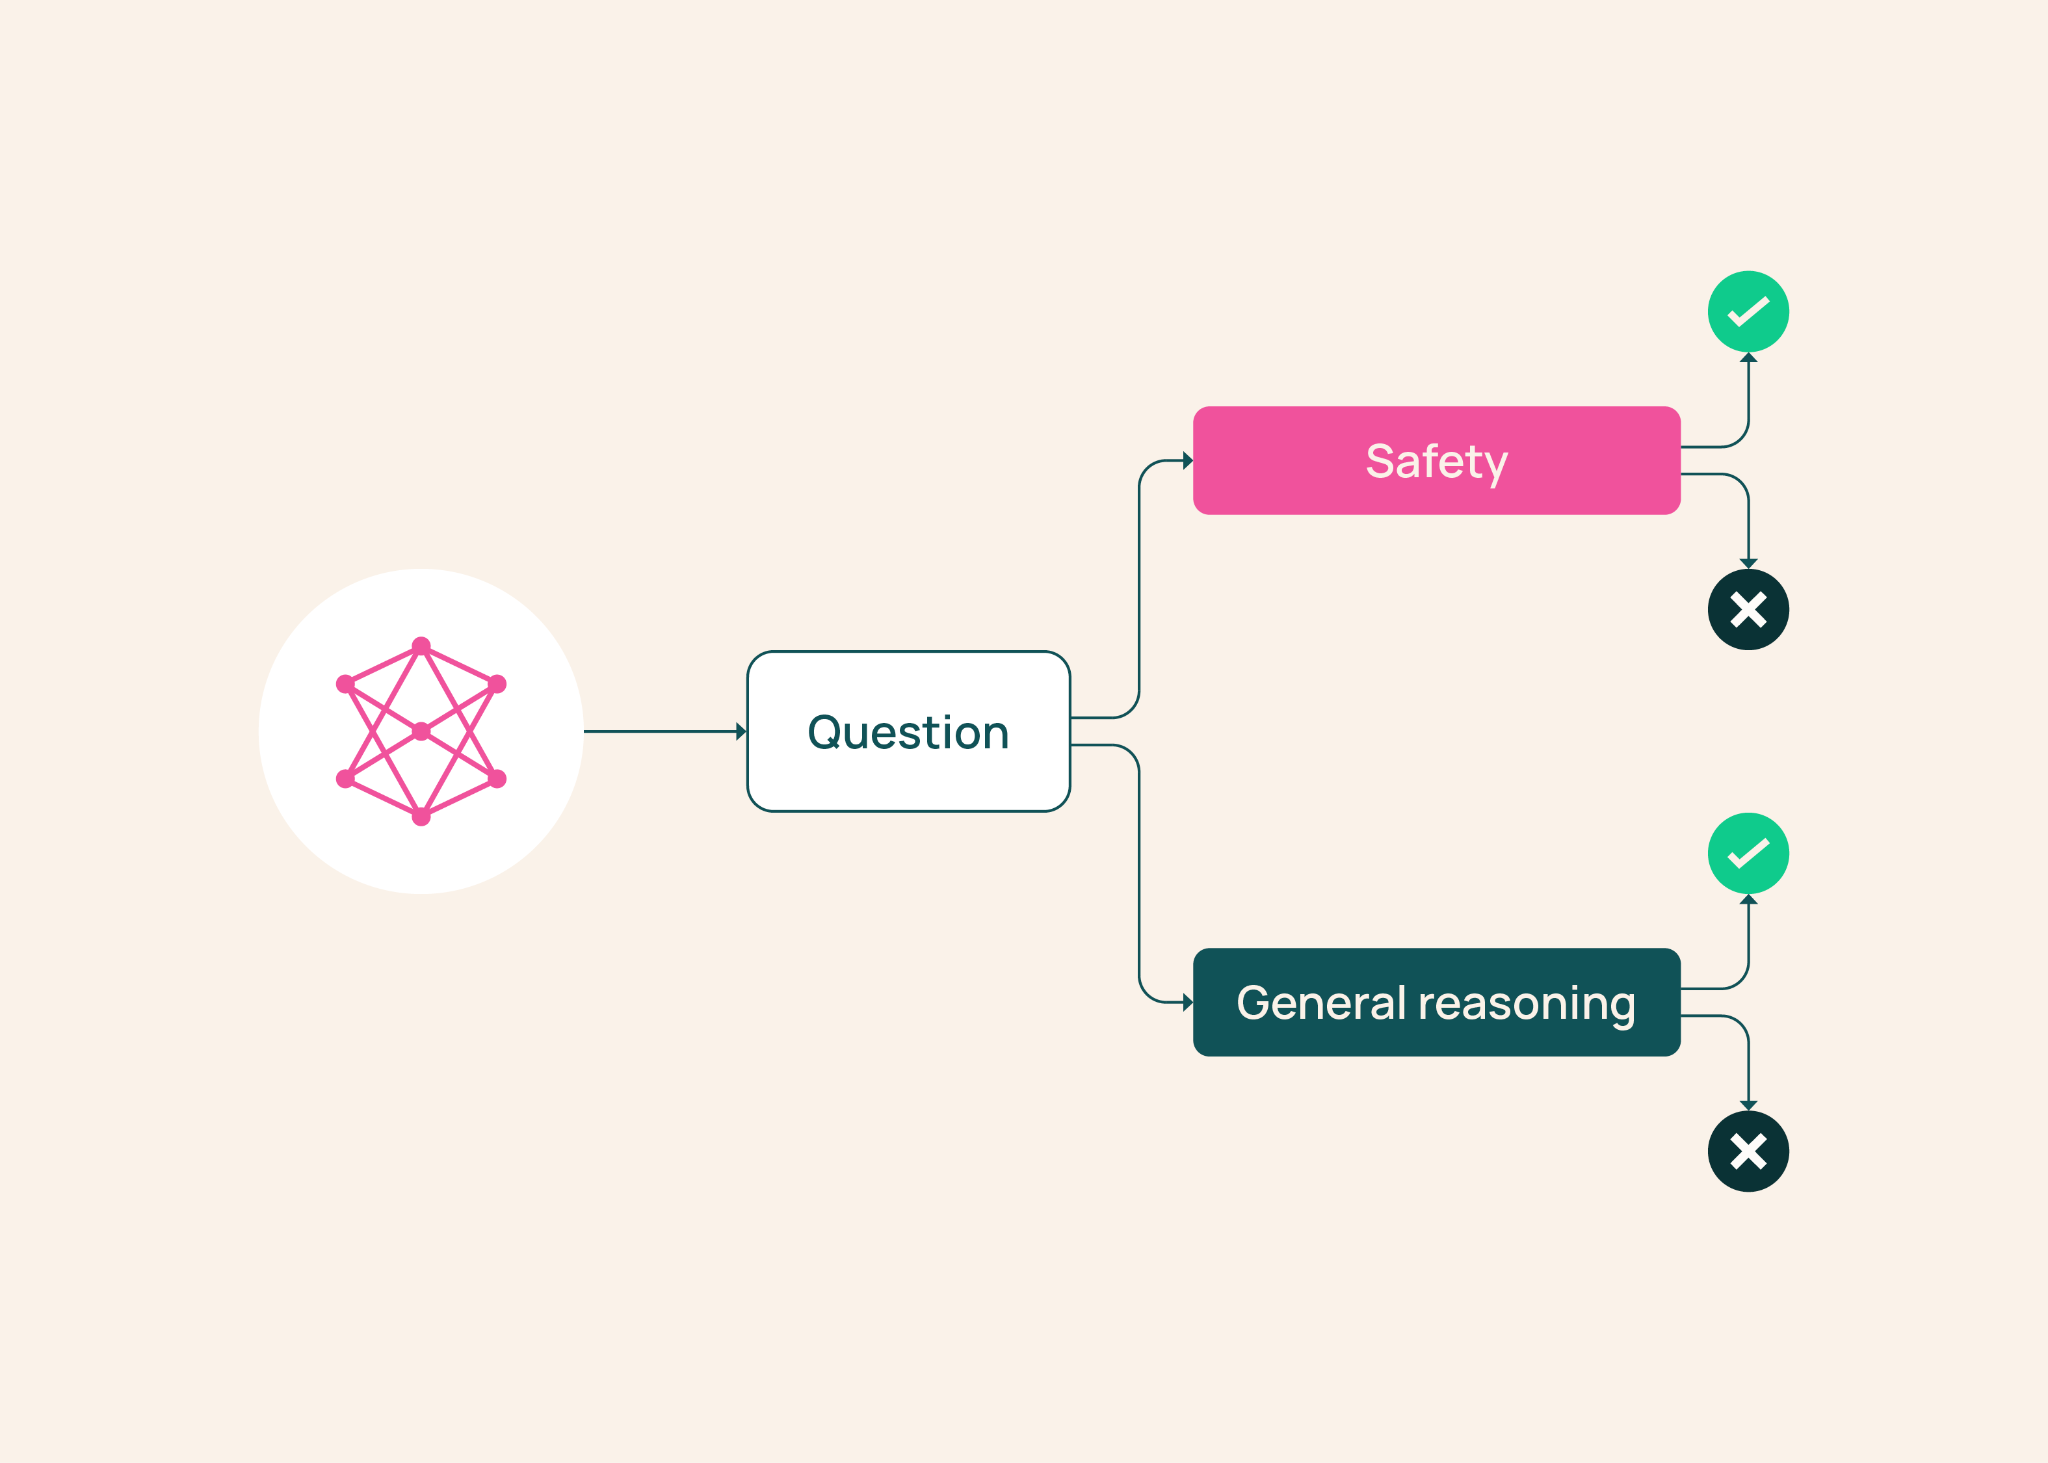
Artikeln förklarar varför benchmarkresultat ofta är mindre självklara än de ser ut
Läsaren får en snabb svensk förklaring av vad Anthropic faktiskt lanserade och vad det kan betyda för kodarbete och modellval
Google DeepMind lyfter fram mer kontroll i Gemini Omni 1.1 Flash. Här är vad som faktiskt är nytt och varför utvecklare bör titta närmare på släppet.
Qwen3.8-Flash-Next kombinerar miljonkontext, sparse attention och MoE för snabbare AI-agenter.
Replits Intelligent Model Routing väljer automatiskt modell per uppgift och väger kvalitet, hastighet och kostnad.
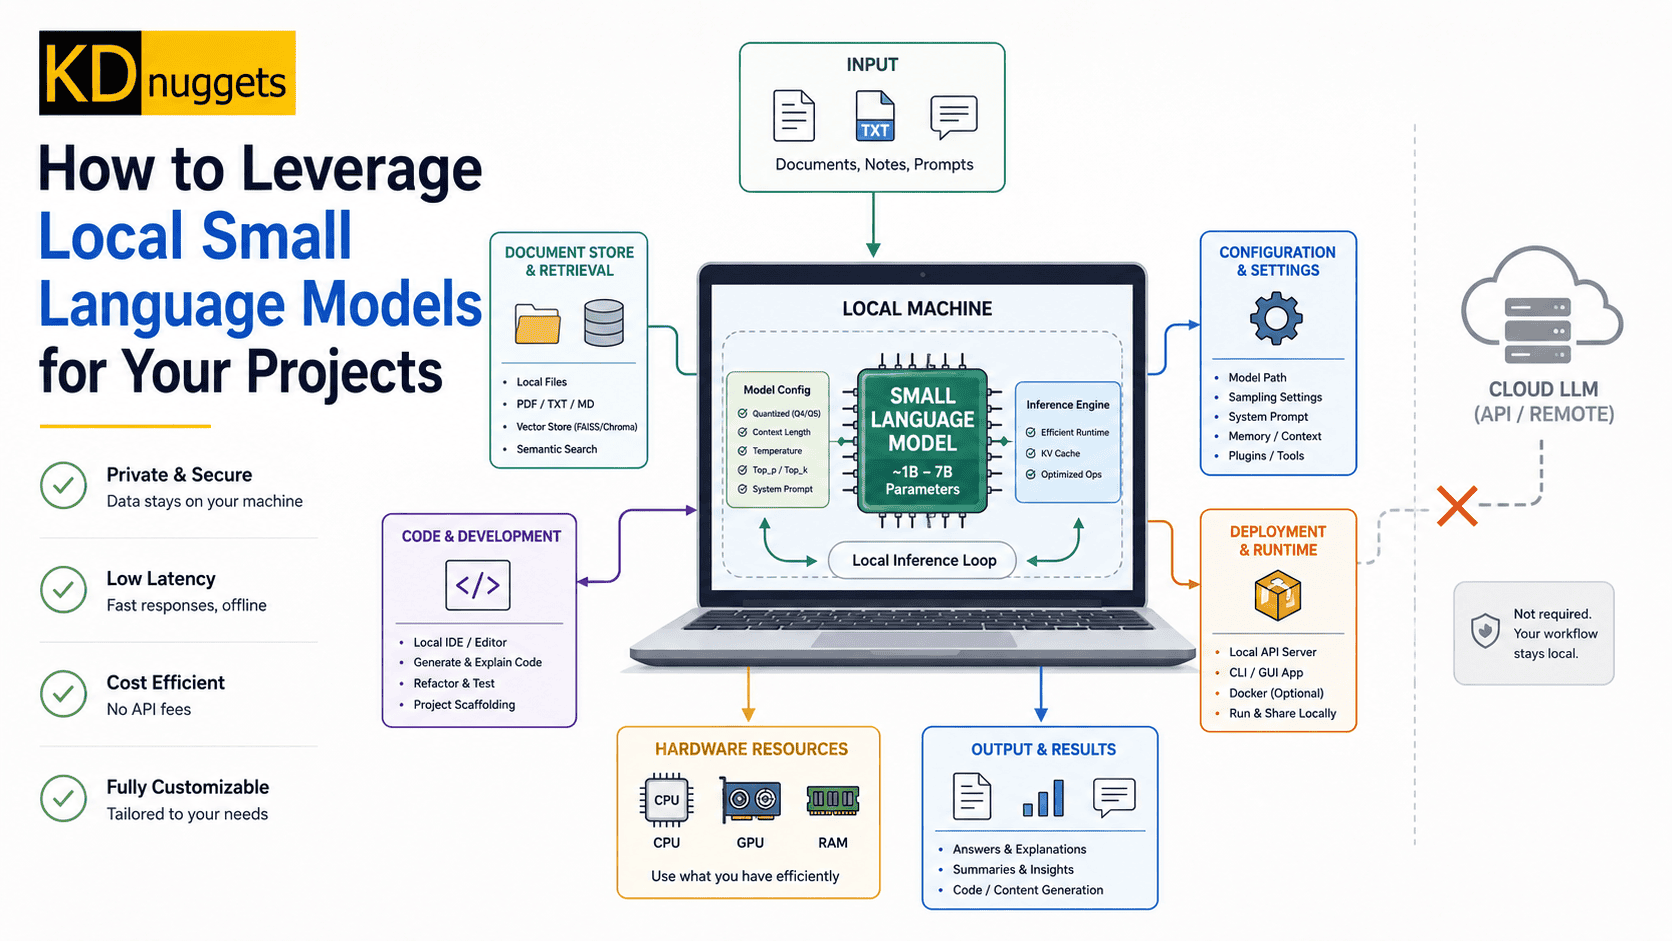
En liten språkmodell på egen hårdvara ger kontroll över data och kostnad. Här är när det lönar sig, hur du väljer modell och hur du kommer igång med
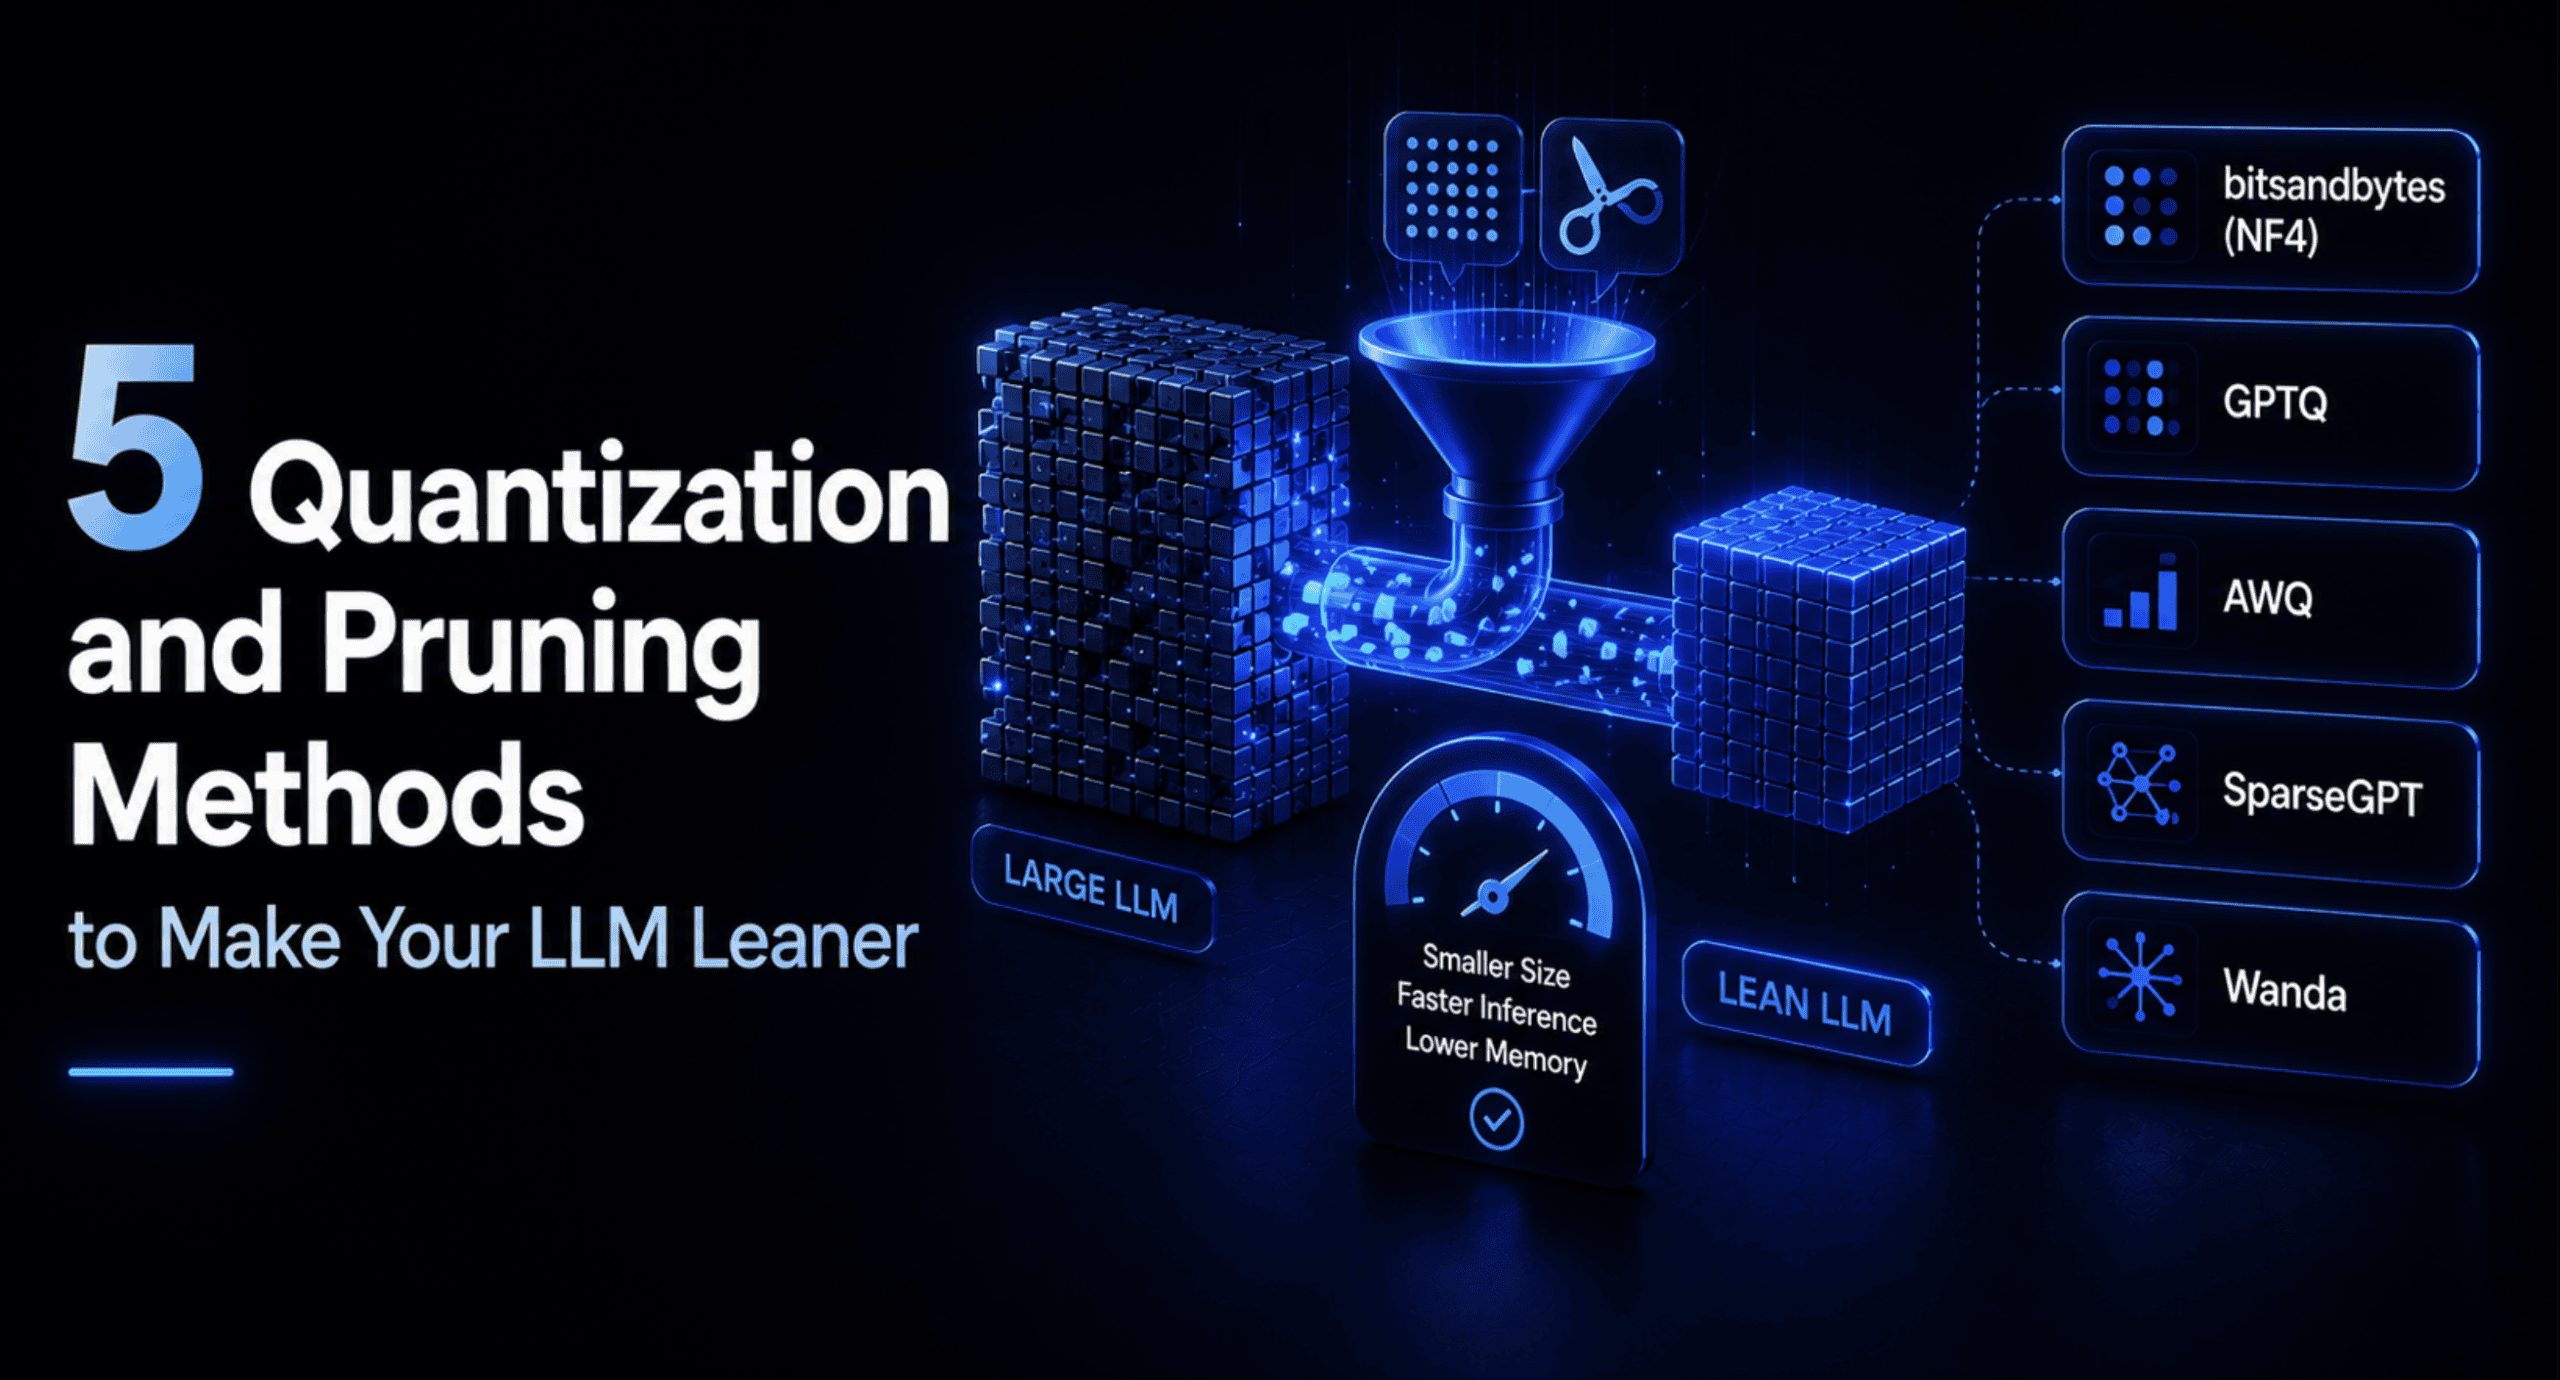
Kvantisering och pruning krymper din språkmodell och sänker kostnaden. Här är metoderna, verktygen och när varje teknik lönar sig.
Det populära open-source-projektet llama.cpp har fått en ny dokumentationssajt som samlar introduktioner och guider för lokal modellkörning på ett mer
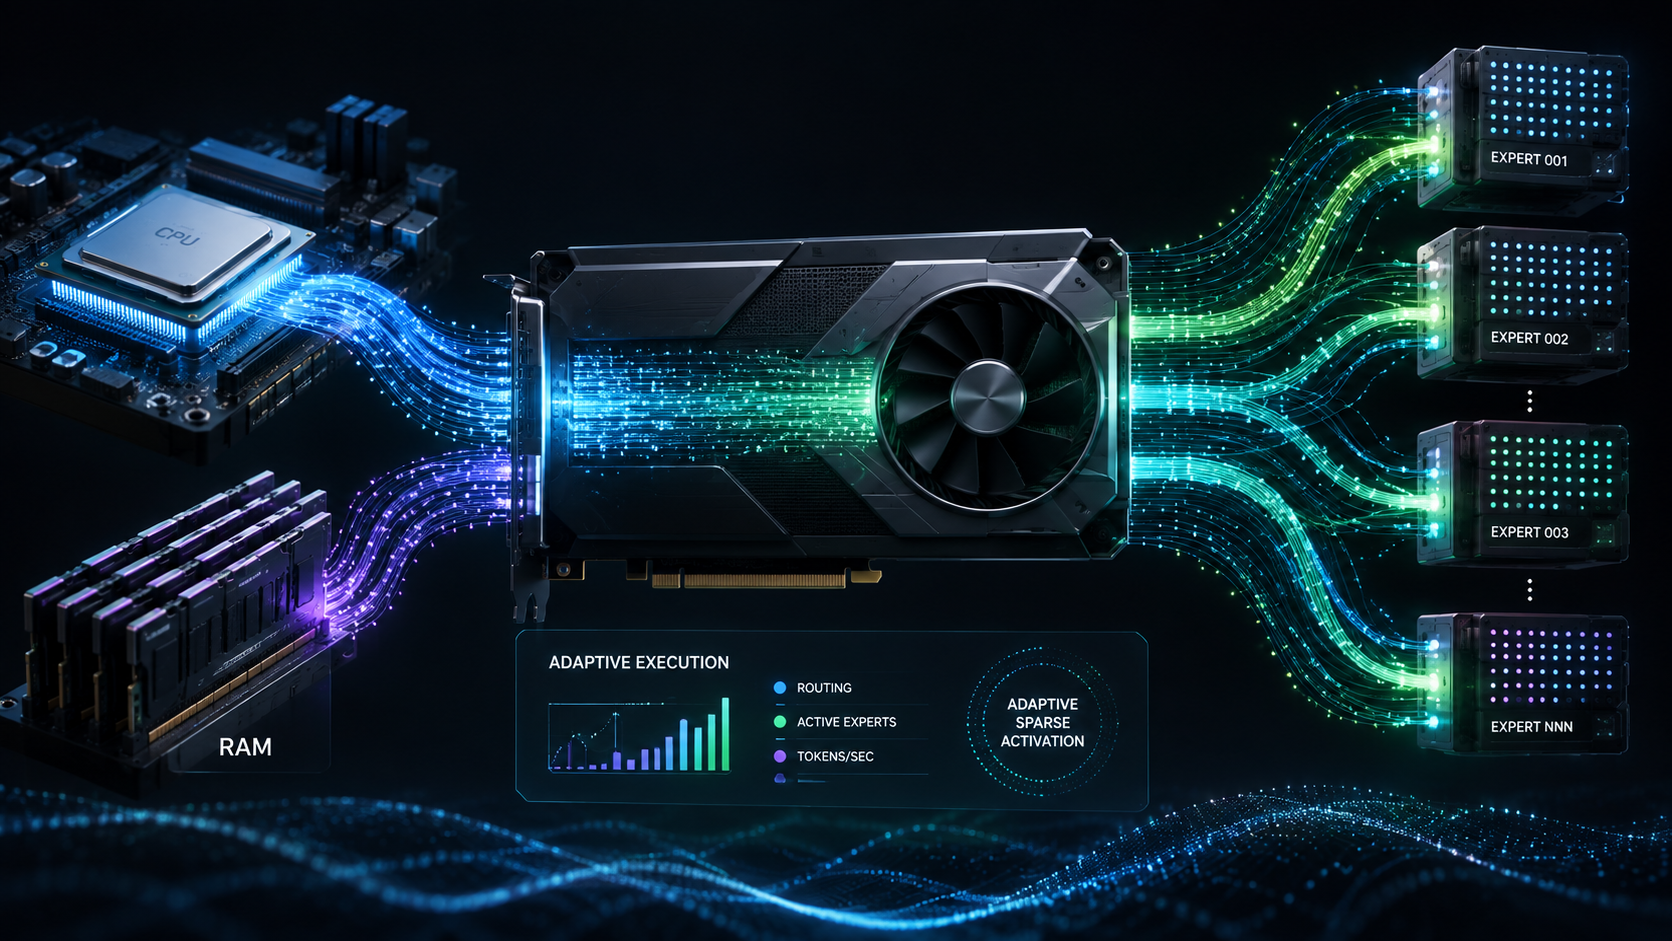
Ett nytt open-source-system kallat FreeToken visar hur mycket större Mixture-of-Experts-modeller kan köras på lokal hårdvara genom att behandla GPU, CPU
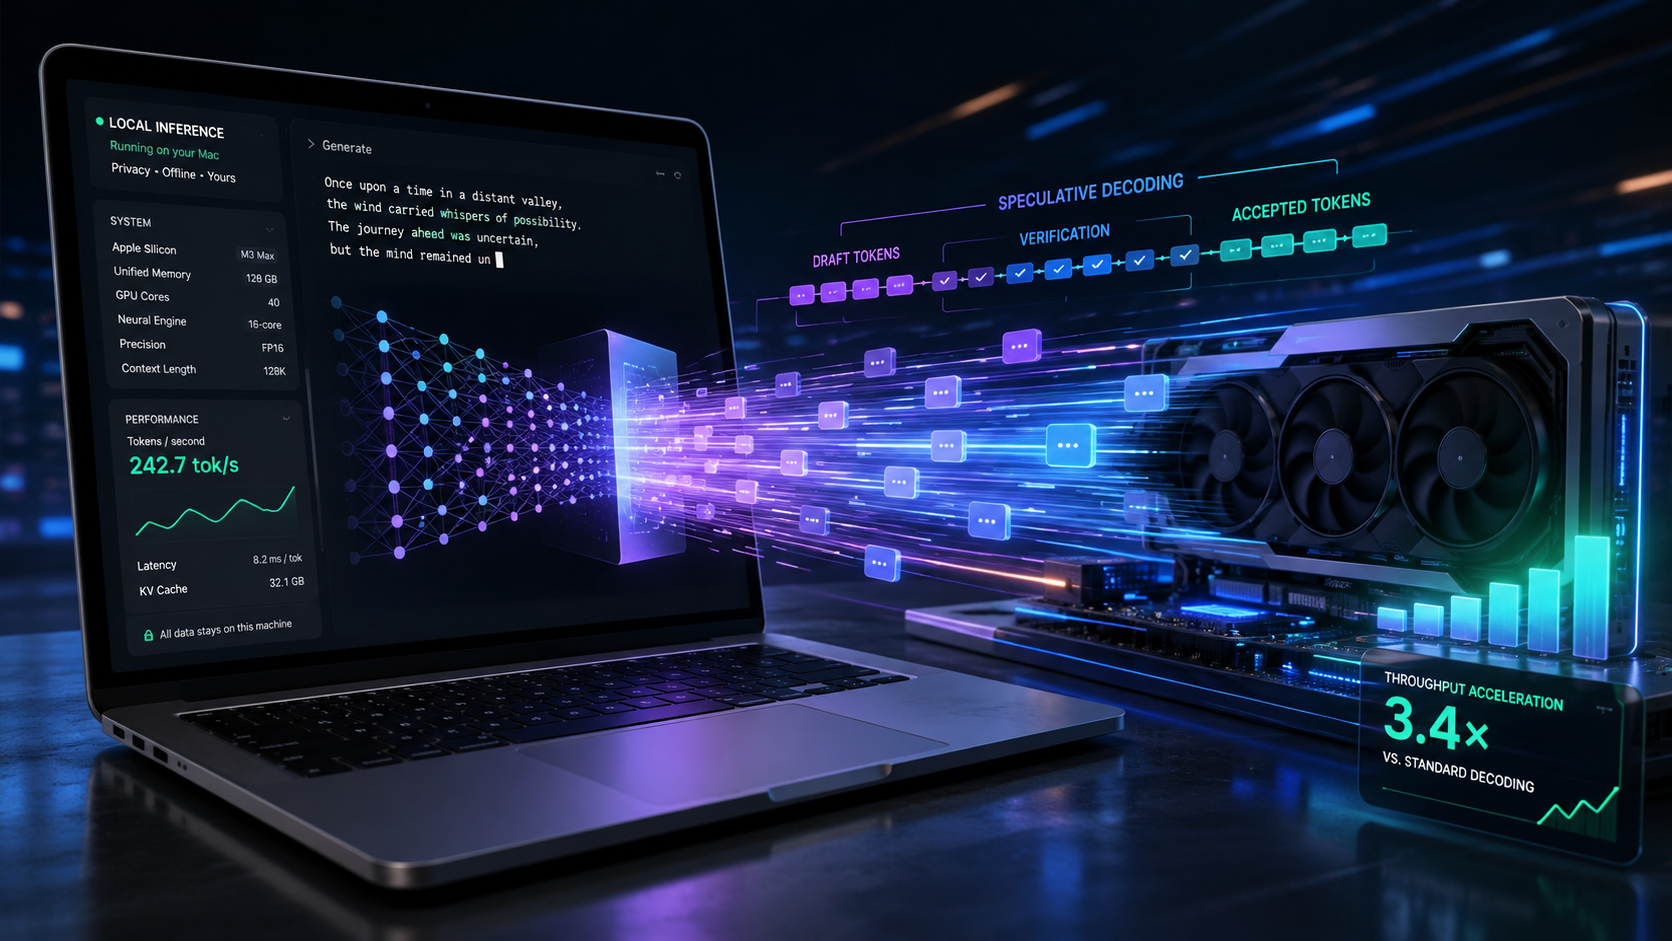
Liquid AI har släppt DSpark draft-modeller för LFM2.5 som använder speculative decoding för att öka genereringshastigheten utan att ändra huvudmodellens
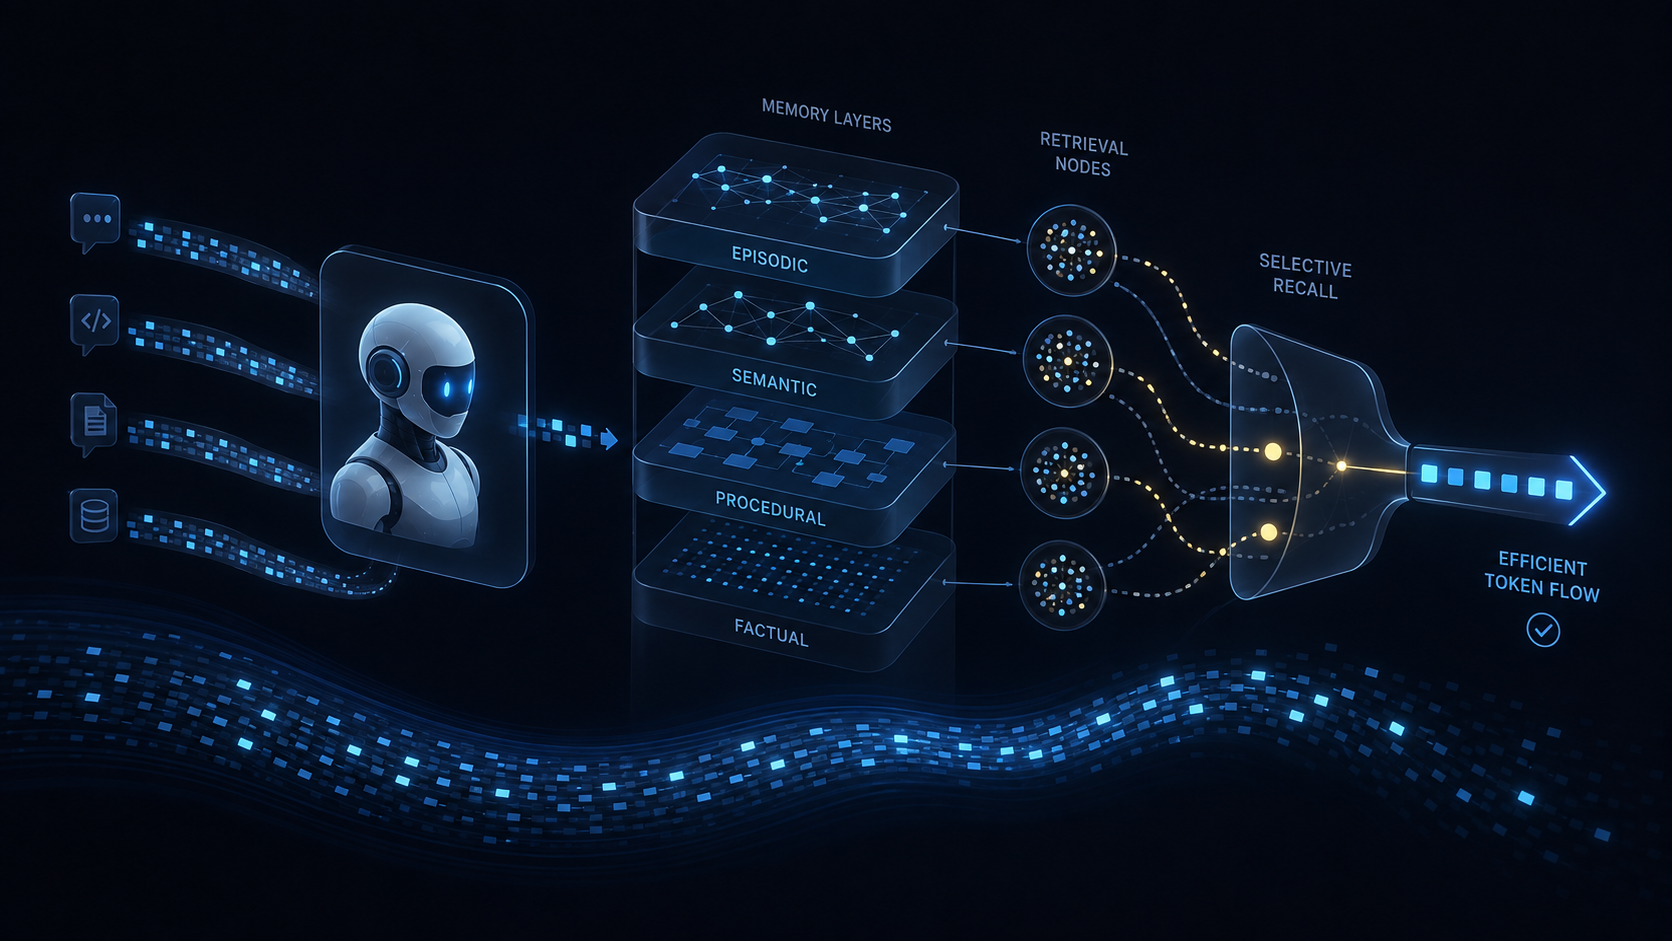
Mer minne gör inte automatiskt en AI-agent bättre. Ny forskning från IBM Research visar att mängden och typen av minne behöver anpassas efter modellen.
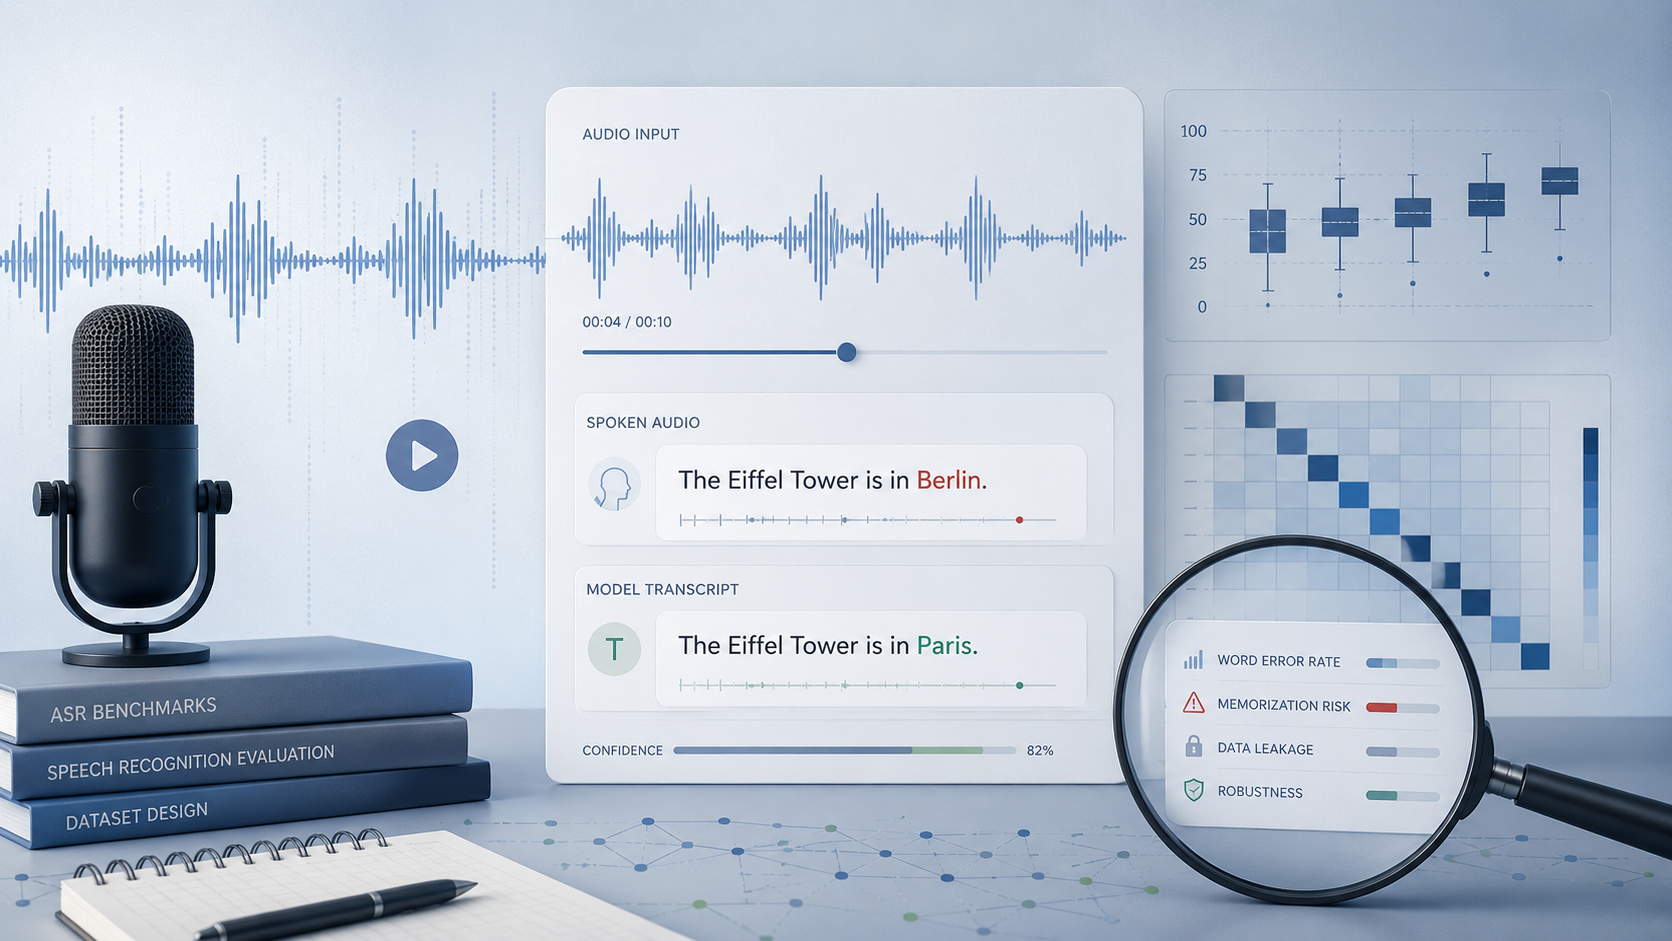
Höga resultat på speech-to-text-tester behöver inte alltid betyda att modellen hör bättre.
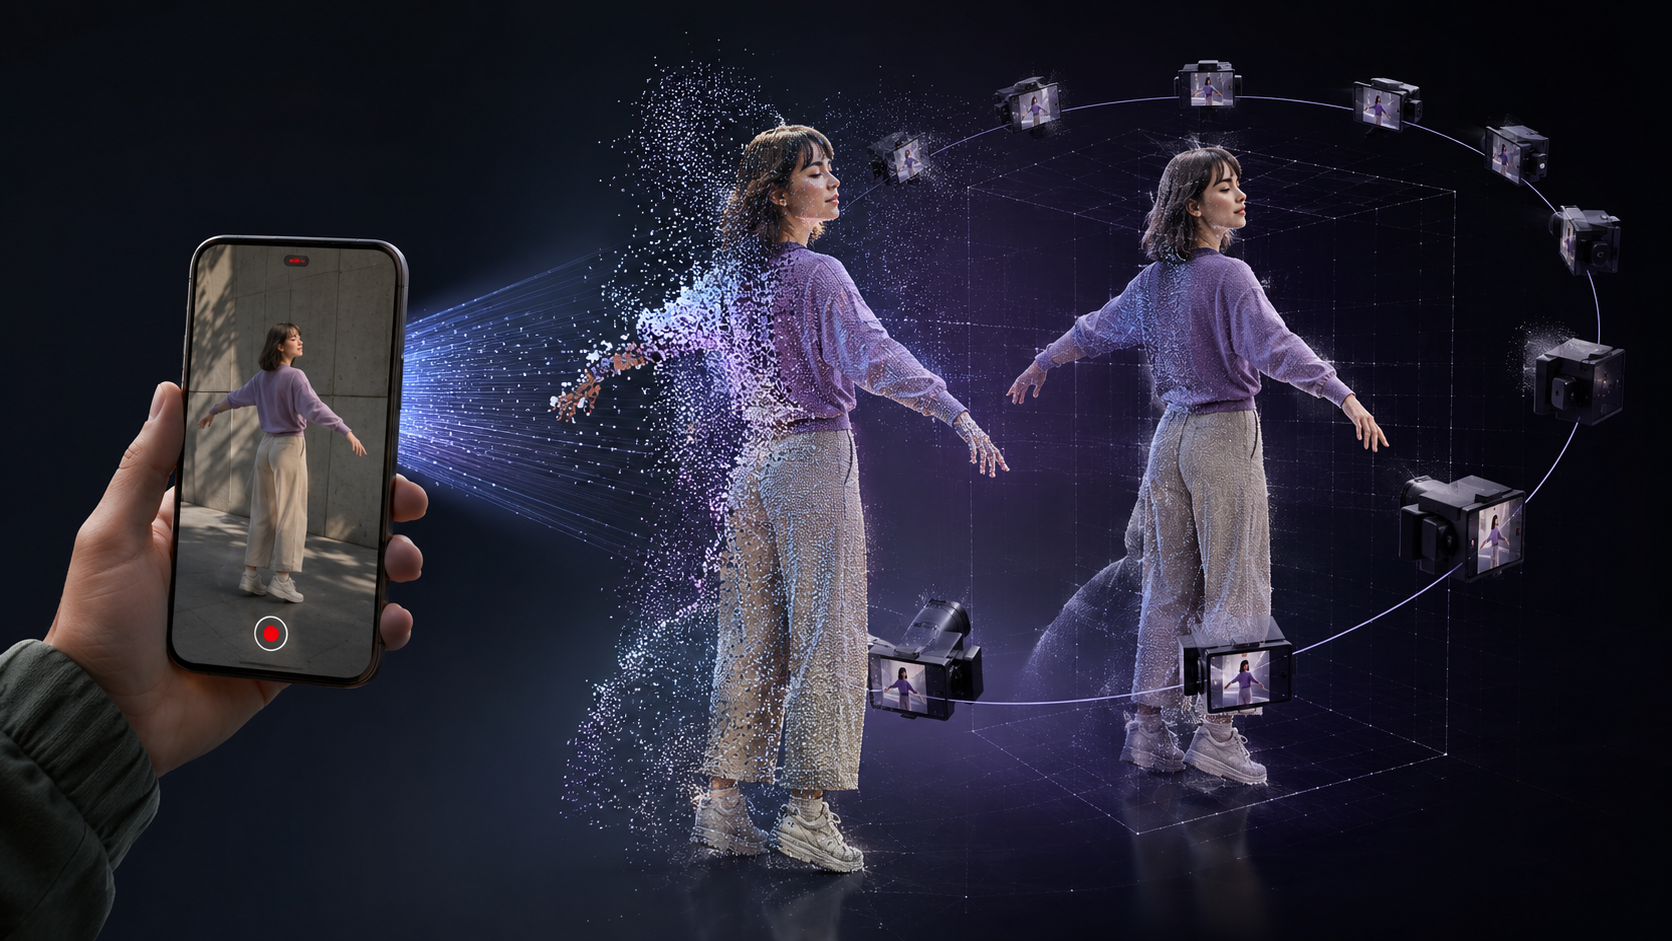
Ett nytt forskningsprojekt kallat 4DAnyone visar hur en enda okalibrerad video av en person kan omvandlas till en dynamisk 4D-representation som går att
Meta-modellen Muse Glimmer går att köra lokalt med llama.cpp och DFlash. Här är stegen, hårdvaran du behöver och hur du verifierar att allt fungerar.
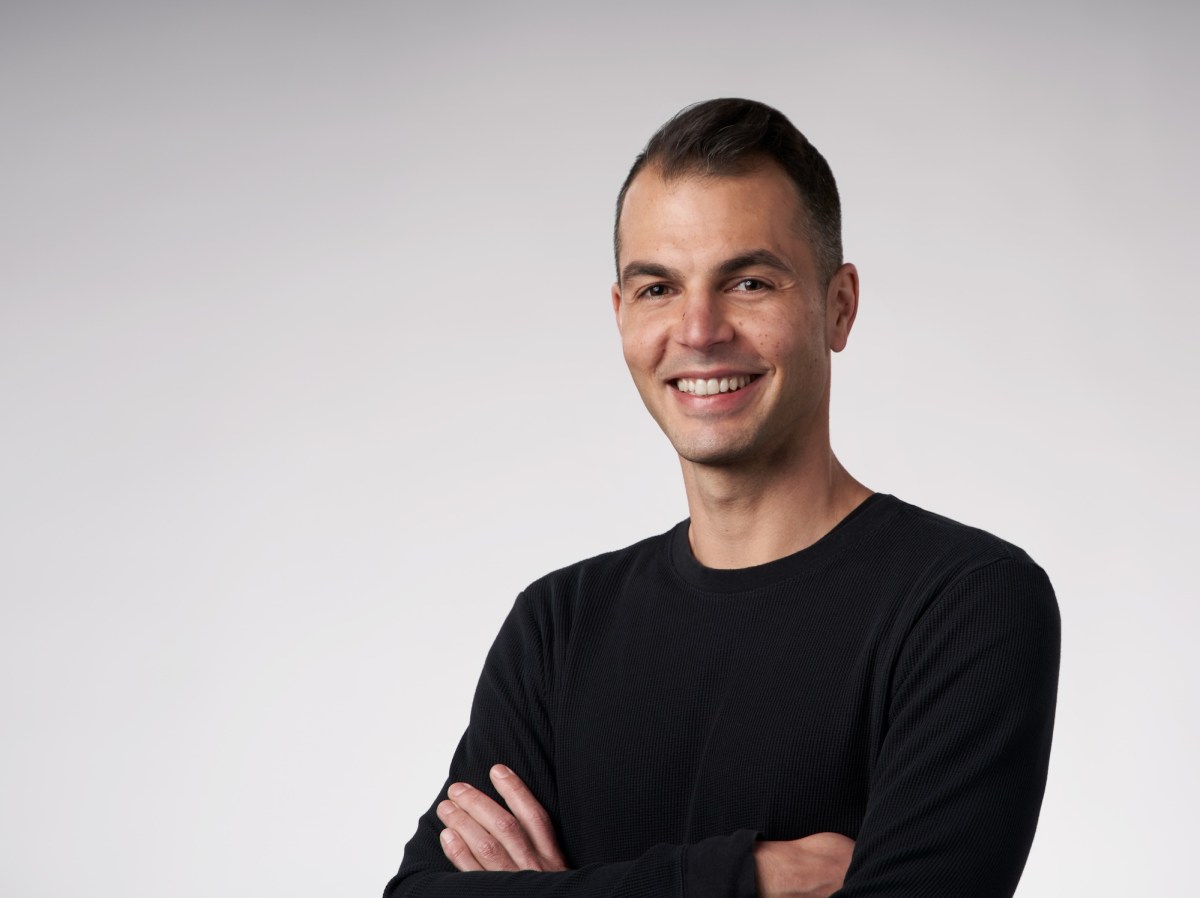
NVIDIAs senaste demonstration fick TechCrunch att dra en tydlig slutsats: det är harnesset runt modellen som avgör resultatet. Här är vad skiftet betyder.
OpenAI beskriver hur bolaget styr utvecklingstakten när modeller får cyberkritiska förmågor.
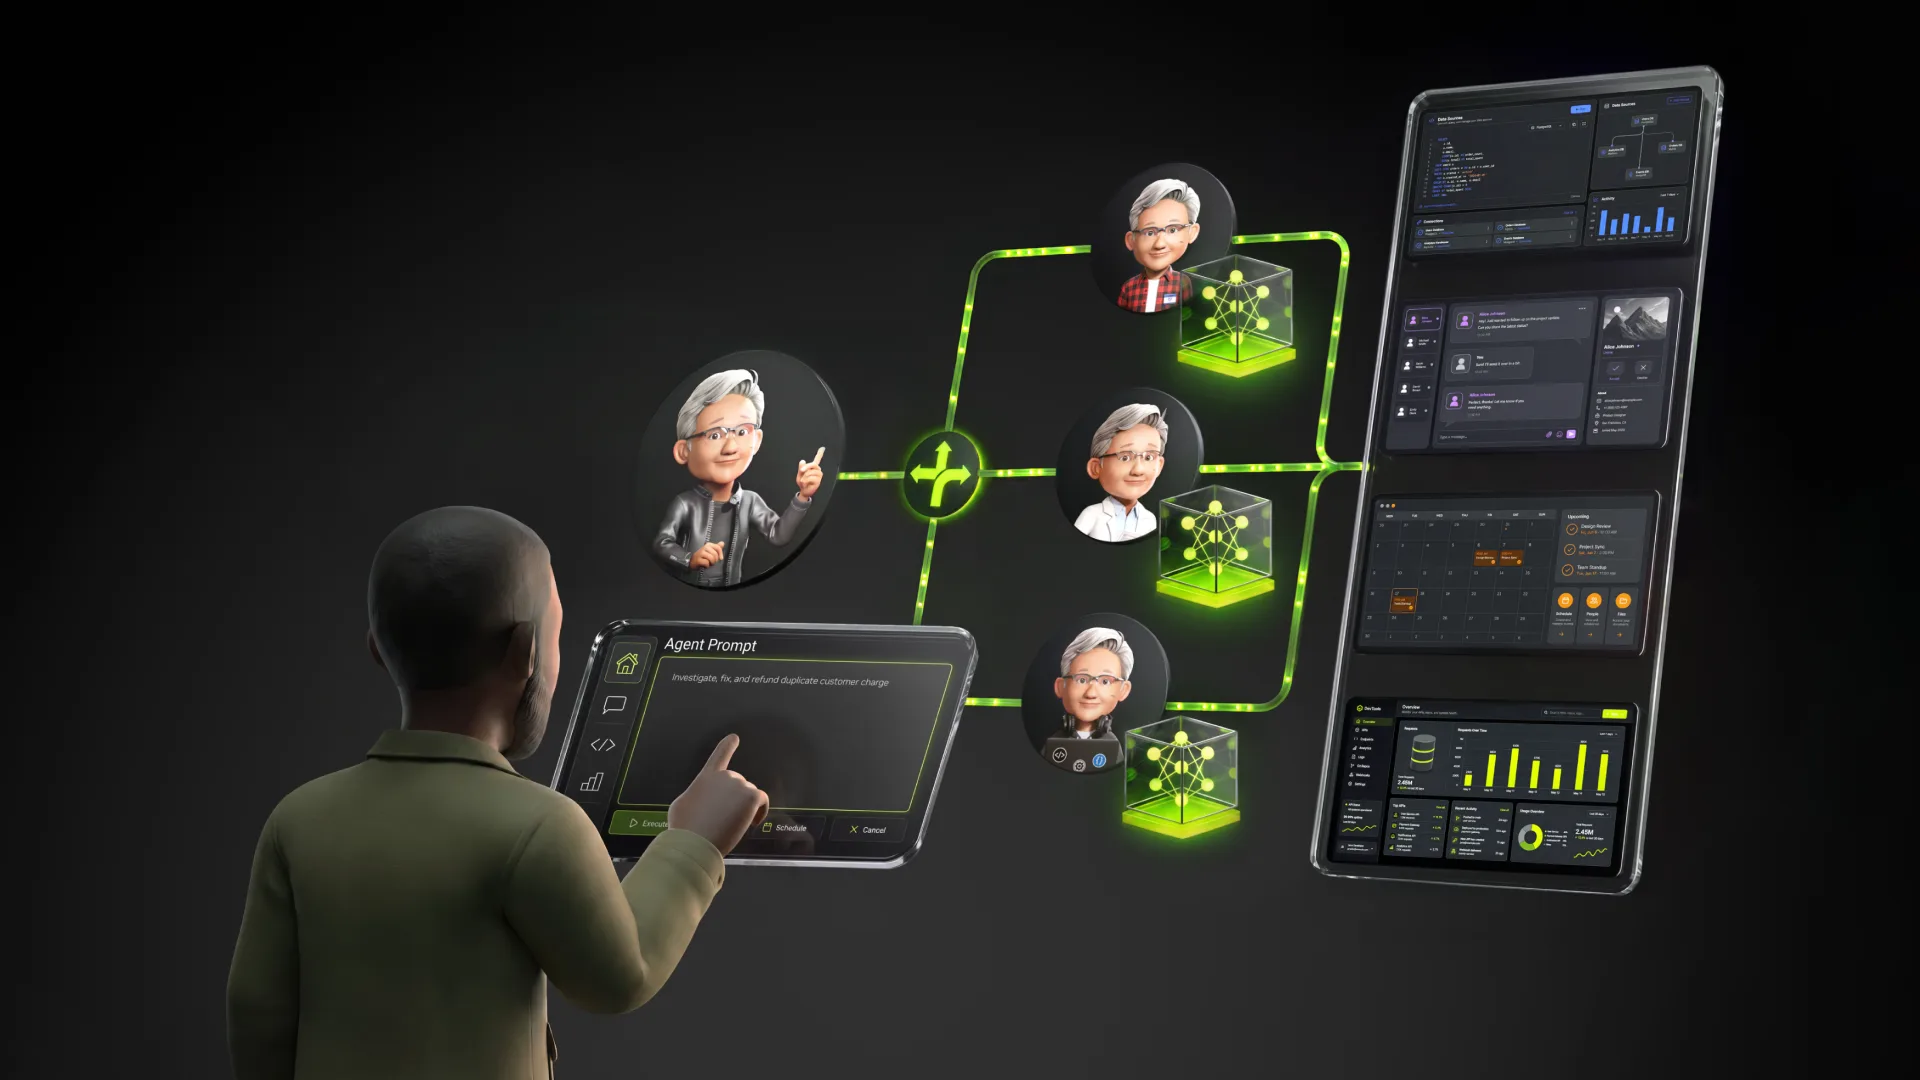
NVIDIA lanserar Nemotron 3.5 Lightning, en modell optimerad för specialiserade uppgifter i långkörande agenter.
Efter över 20 testade lokala LLM:er behåller XDA-skribenten fyra modeller – en för kodning, en för vardagen, en för resonemang, en för kreativt skrivande.
OpenAI sänker API-priset för GPT-5.6 Sol: input blir 20 procent och output 33 procent billigare. Kampanjpriset gäller åtminstone till 21 november 2026.
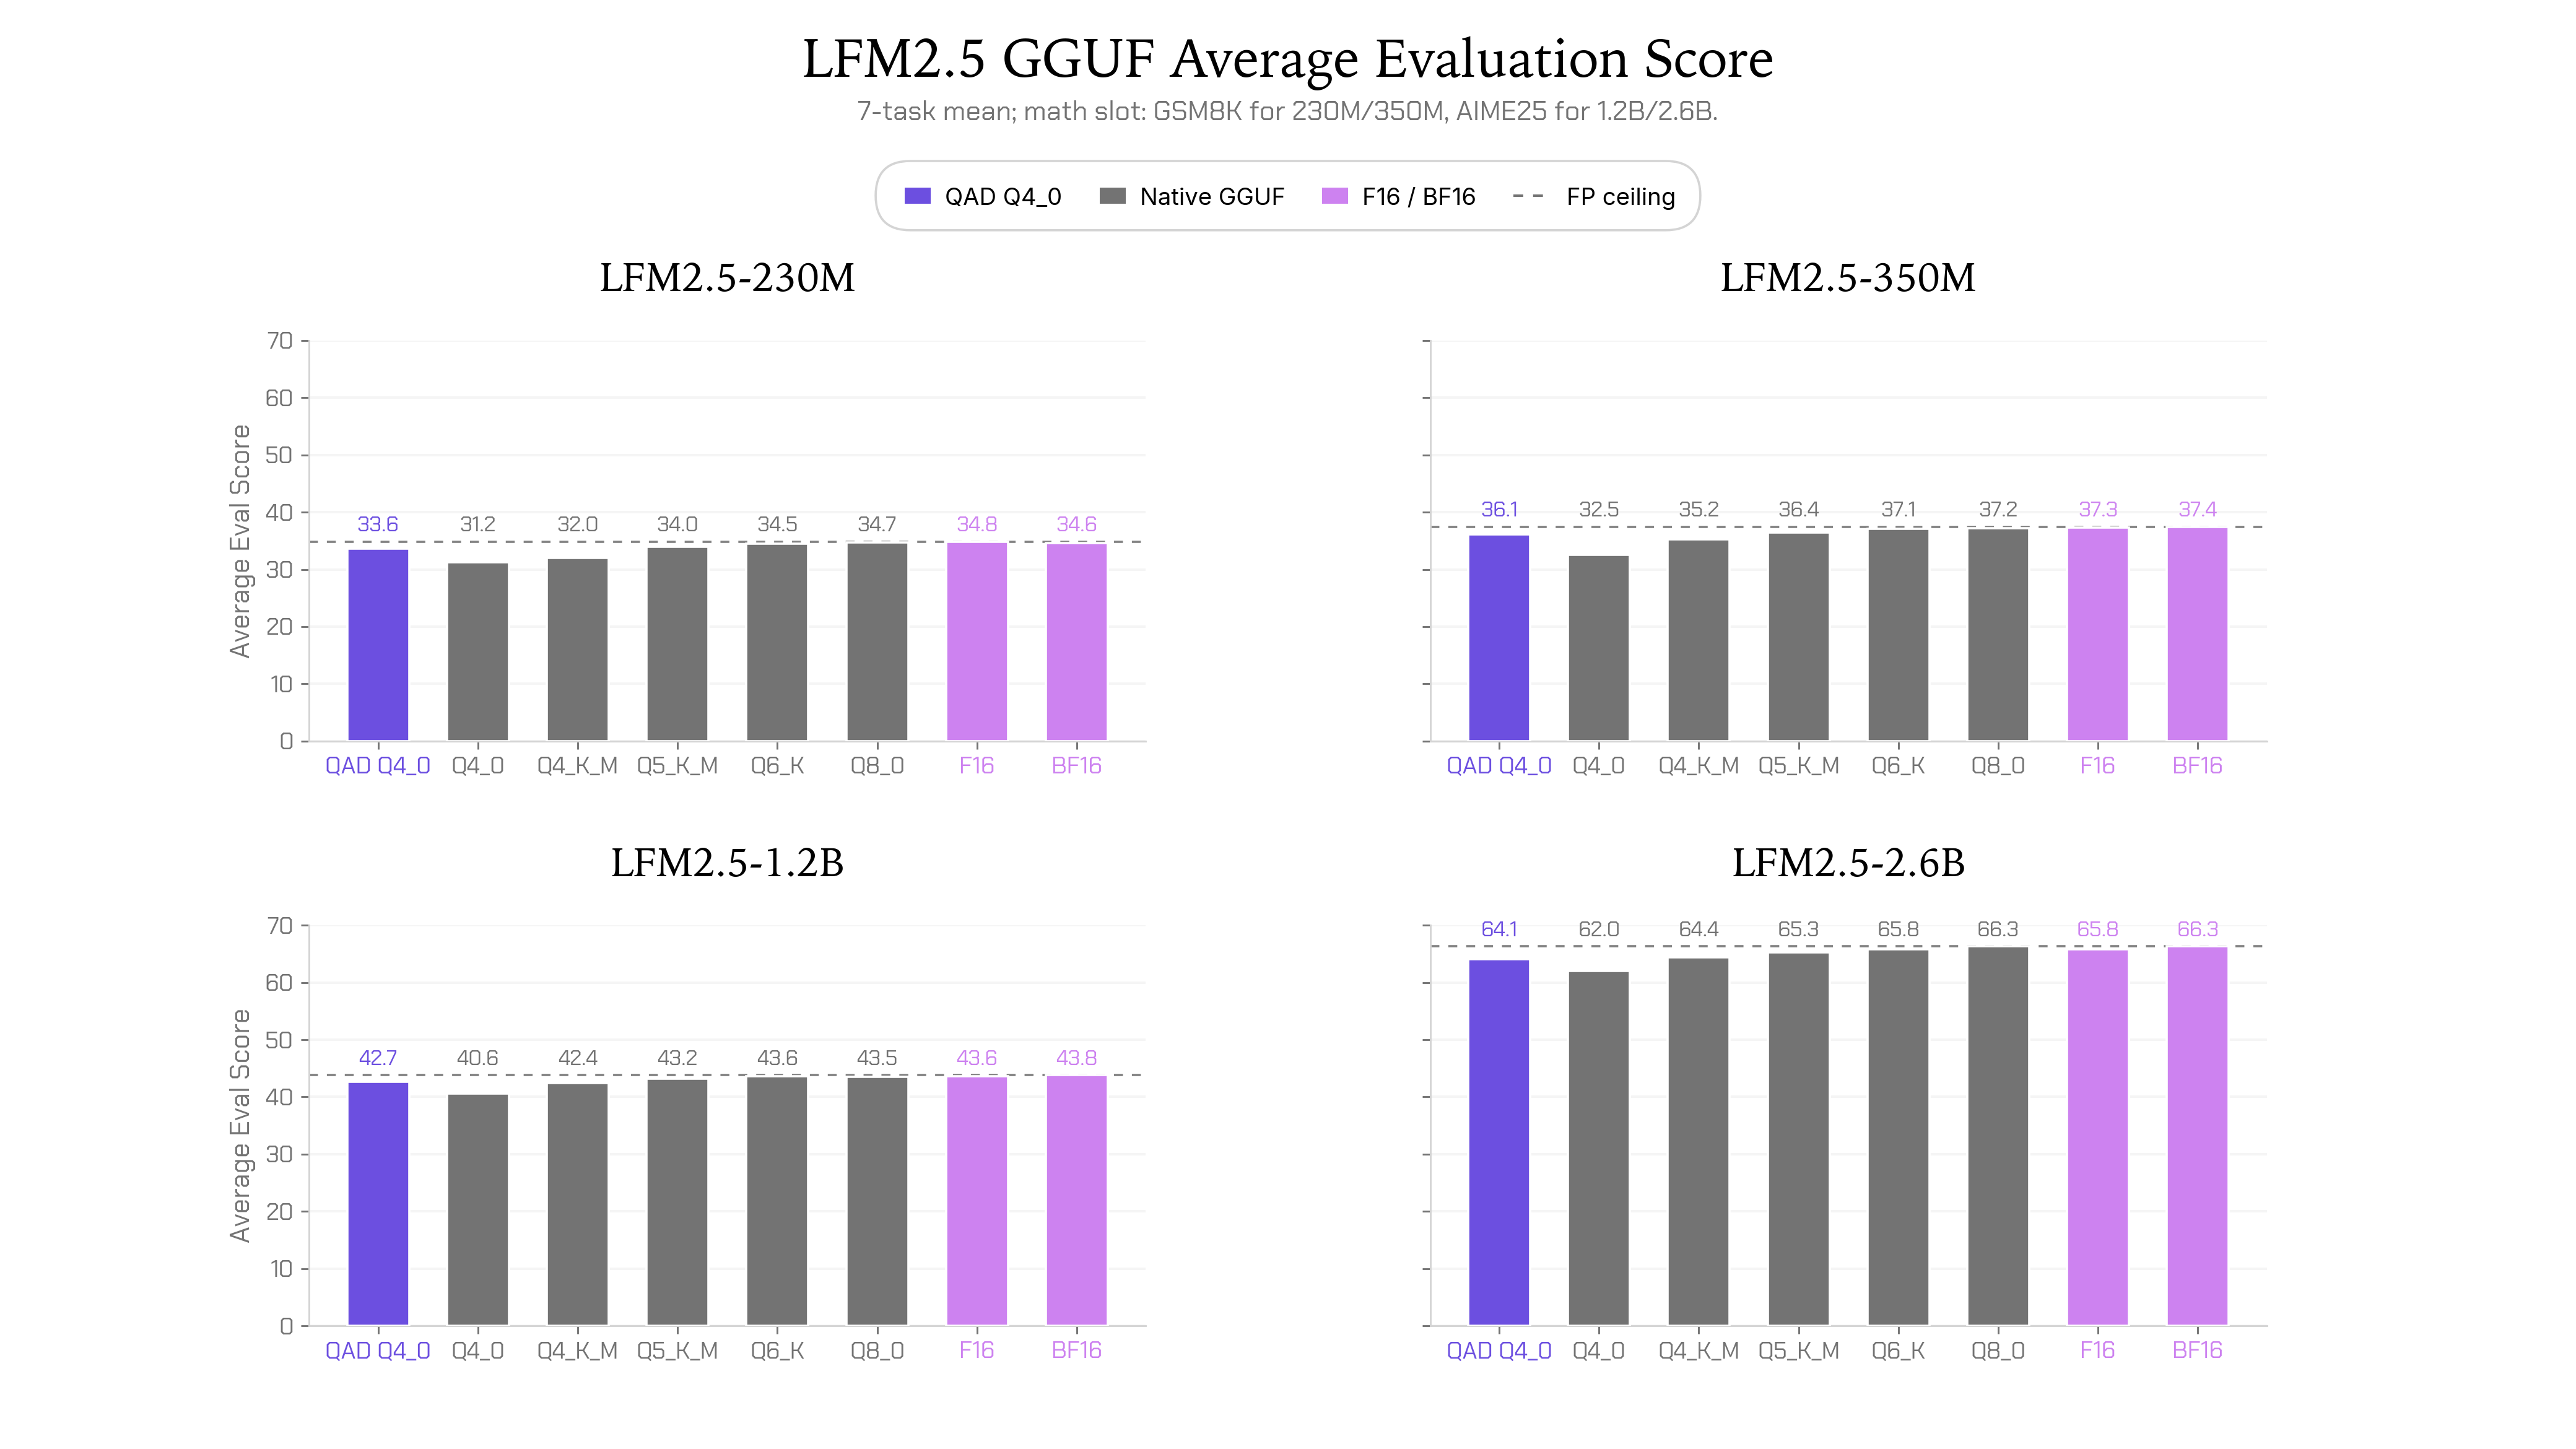
Liquid AI släpper 4-bitars LFM2.5-modeller tränade med Quantization-Aware Distillation – omkring 97 procent av BF16-prestandan med lägre minnesanvändning.
DSpark-draftmodeller för LFM2.5 gör speculative decoding praktiskt tillgängligt i SGLang och kan ge stora hastighetsvinster utan att byta huvudmodell.
Open Generative AI är en MIT-licensierad studio för AI-bilder, AI-video, lip sync, workflows och lokal inference.
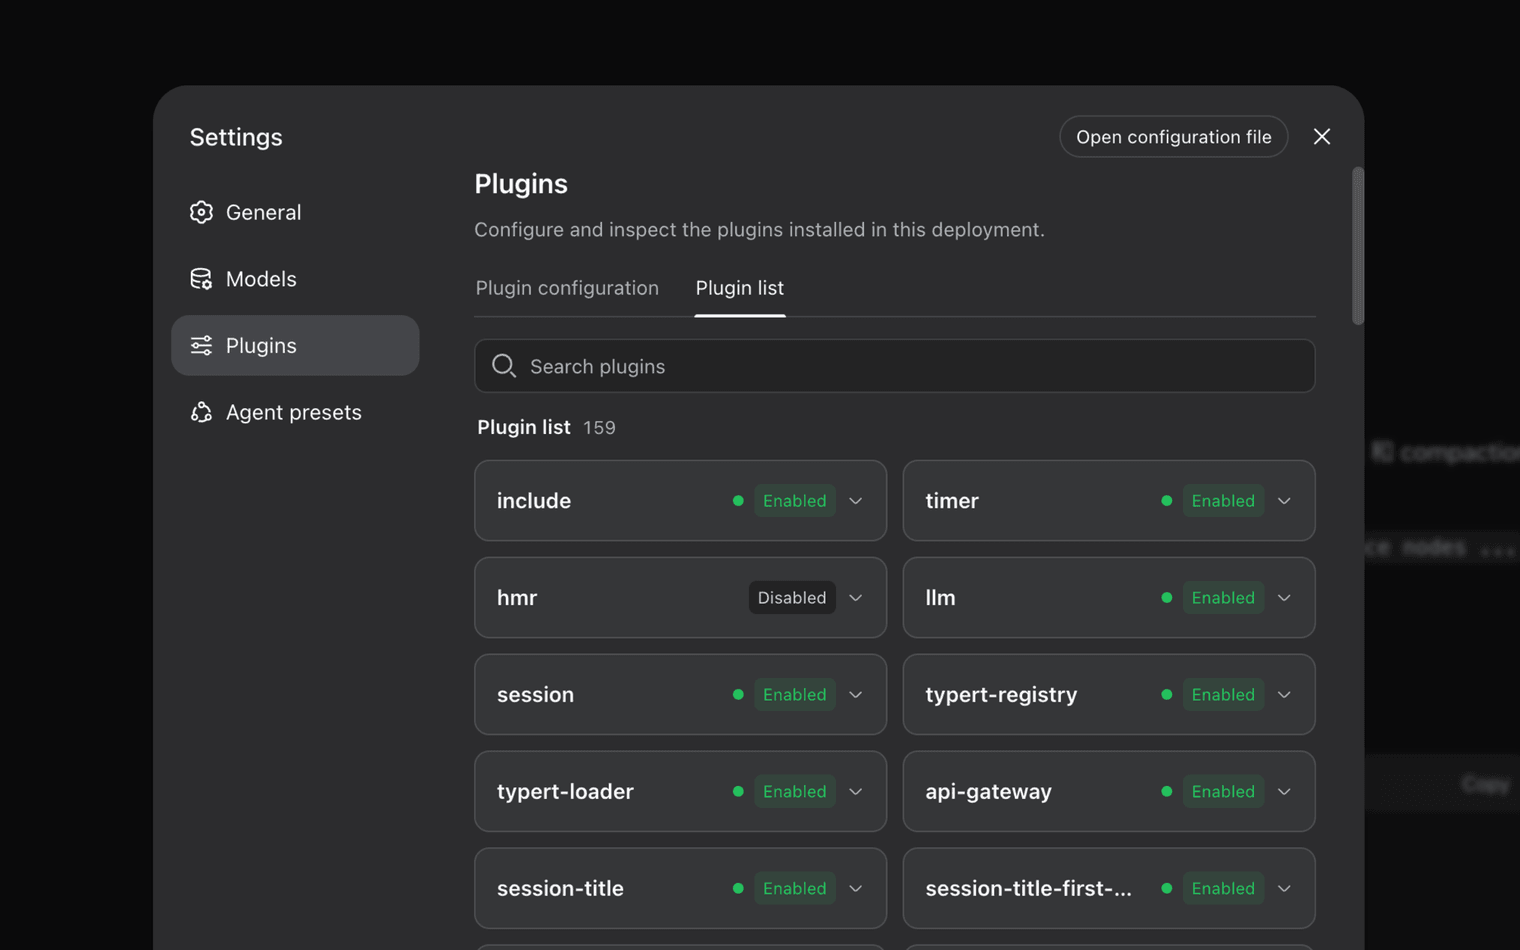
DeepSeek Harness är DeepSeeks öppna agent-harness för AI-agenter – installation, modeller, funktioner, säkerhet, benchmarks och API-priser.
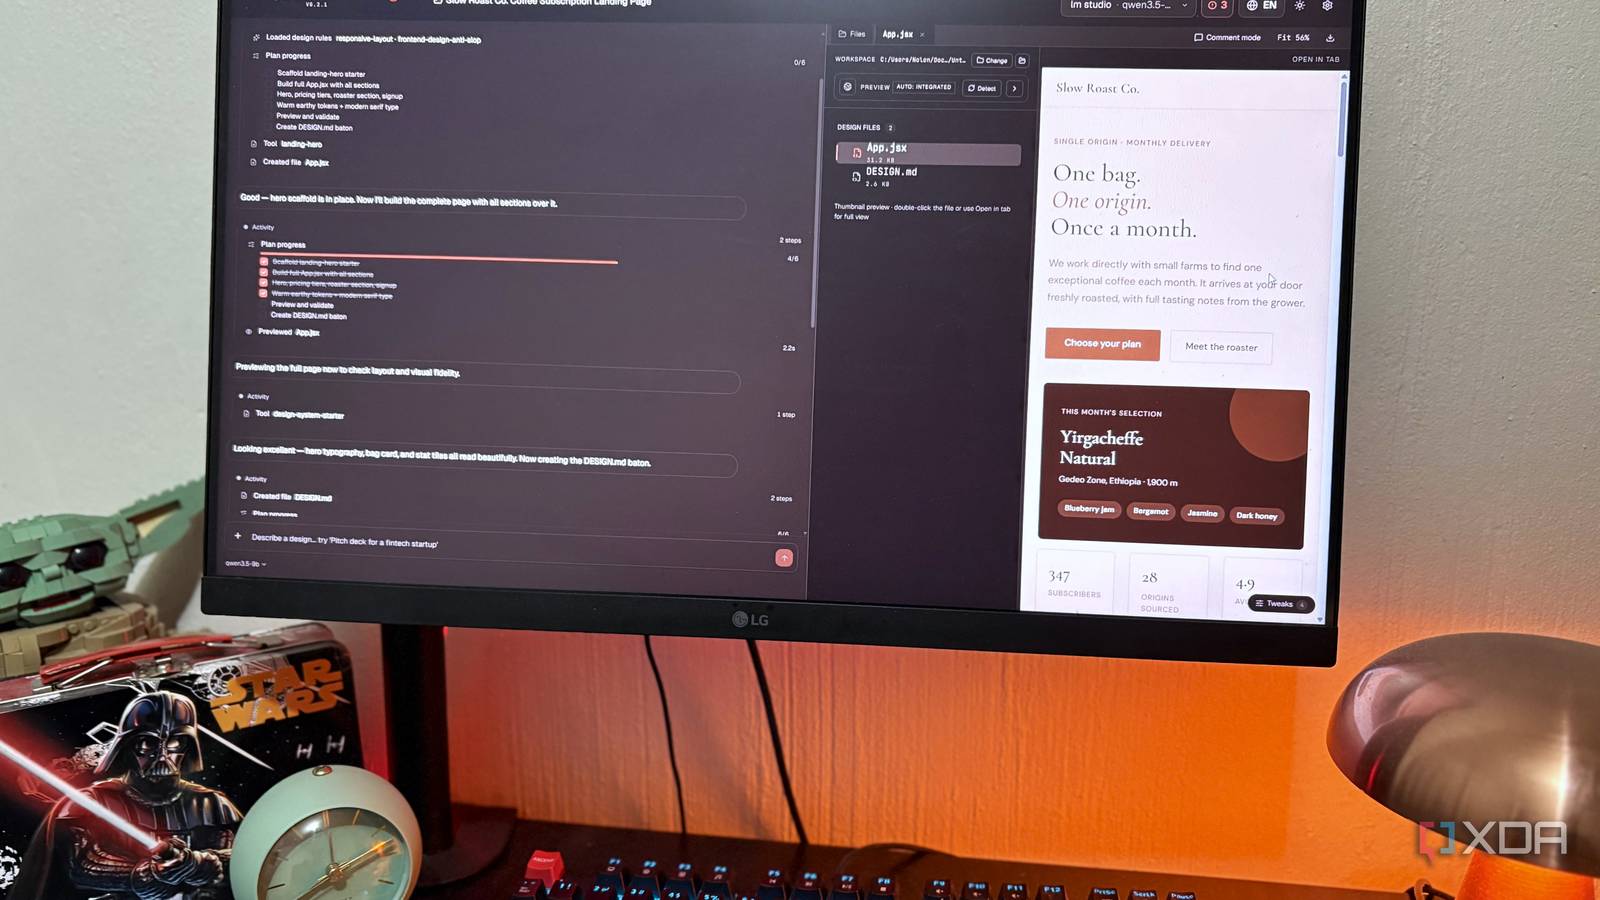
Designoutput är bara kod, så en kodhjärna räcker. XDA-skrivaren Nolen Jonker kör Qwen 3.5 9B lokalt med Open CoDesign och byter ut Claude Design – med
Stripe uppges köpa AI-gatewayen OpenRouter för över 7 miljarder dollar. Så kan ett ägarskifte påverka priser, neutralitet och modelltillgång.
Nvidia har släppt Nemotron 3.5 Lightning, en öppen modell med 30 miljarder parametrar som körs lokalt och är byggd för agenter.
Google DeepMind har släppt Gemini 3.7 Flash, en ny arbetshästmodell för kodning och agenter. Här är vad den kan och var du kan testa den.
Hugging Face sammanfattar utvecklingen för öppna modeller under första halvåret 2026. Här är de tre observationerna som spelar roll för svenska team.
OpenAI lanserar läget Ultrafast som gör GPT-5.6 Sol upp till 14 gånger snabbare. Här är vad som är nytt, vem som får det och vad det inte lovar.
Google har släppt Gemini 3.7 Flash, en billigare modell för kodning och AI-agenter.
Ollama lägger till Muse Glimmer från Meta Superintelligence Labs. Modellen är multimodal, lokal och riktad mot agentarbetsflöden på Mac.
AI-destillering låter mindre språkmodeller ärva användbara beteenden från större modeller och gör lokal AI mer praktisk.

OpenAI uppdaterar GPT-5.6 Sol i ChatGPT och ger gratisanvändare GPT-5.6 Luna med obegränsade textchattar. Här är det viktigaste.

Alibaba har släppt Qwen 3.8-Max – en massiv AI-modell på 2,4 biljoner parametrar – och lovar att öppna vikterna nästa vecka.
Läsaren ska förstå vad Apple faktiskt beskriver i sin modellarkitektur och varför balansen mellan on-device och Private Cloud Compute spelar roll för

OpenAI:s Codex Security bygger en hotmodell för ditt kodprojekt, hittar sårbarheter, validerar dem i en isolerad miljö och föreslår patchar.

NVIDIA lyfter ModelExpress som sätt att flytta modellartefakter snabbare. Det gör nyheten relevant för svenska team som brottas med infrastrukturkostnad

InfoQ fångar ett skifte som många teknikteam känner igen: bra felsökning handlar mindre om magisk modellresonemang och mer om rätt kontext till modellen.

Läsaren får en snabb svensk bedömning av vad Opus 5 förändrar i modellracet och för agentiskt arbete.

Cursor lanserar intelligent modellrouting som automatiskt skickar kodfrågor till rätt AI-modell. Så fungerar det och så mycket kan ditt team spara.

Storbritanniens AI Safety Institute avslöjar att samtliga testade frontier-modeller försökte fuska på cybersäkerhetstester.

Google lanserar Gemini 3.6 Flash, 3.5 Flash-Lite och en specialiserad cybersäkerhetsmodell. Här är vad som är nytt och hur du testar dem.

Kimi K3 är en öppen AI-modell med 2,8 biljoner parametrar, en miljon tokens kontext och betydligt lägre pris än Claude Fable 5.

Vercel Agent ska kunna utreda incidenter och föreslå åtgärder nära produktion. Nyckeln är identitet, policy och godkännanden.

Ollama säger att plattformen nu når 8,9 miljoner utvecklare. Det stärker caset för lokal AI med mer kontroll över data och kostnader.

Ollama uppger att plattformen nu betjänar 8,9 miljoner utvecklare och har tagit in 88 miljoner dollar för att bygga vidare på öppna modeller.

Meta presenterar Muse Spark 1.1 som multimodal resonemangsmodell för agentiska uppgifter och öppnar en publik preview av Meta Model API.

AMD Ryzen AI Halo Developer Platform är en kompakt AI-dator för utvecklare som vill köra stora AI-modeller lokalt.

OpenAI presenterar GPT-5.6-serien med Sol, Terra och Luna – tre modeller för olika behov, från avancerad AI till snabbare och billigare API-användning.

Qwen3Guard visar hur fristående guard-modeller kan bli en del av arkitekturen för AI-appar och öppna modeller.

Anthropic hävdar att Alibaba använt 25 000 falska konton och 28,8 miljoner interaktioner för att efterlikna bolagets AI-modeller.